
ArticleFinance & statistiques
Illiquidity-at-Risk : mesurer les assèchements extrêmes de liquidité
Une présentation pédagogique d’IlliQaR et du rôle des sauts dans la prévision de la liquidité.
Éditorial / 22 publications
Des méthodes et des tutoriels lisibles hors ligne pour tester les outils, vérifier leurs limites et construire des workflows durables.
À lire
Une présentation pédagogique d’IlliQaR et du rôle des sauts dans la prévision de la liquidité.
Une séquence générique pour préparer un serveur, lancer un service et vérifier qu’il reste administrable.
Comment un modèle génératif de microstructure relie flux d’ordres, liquidité et replay dans un moteur d’appariement.
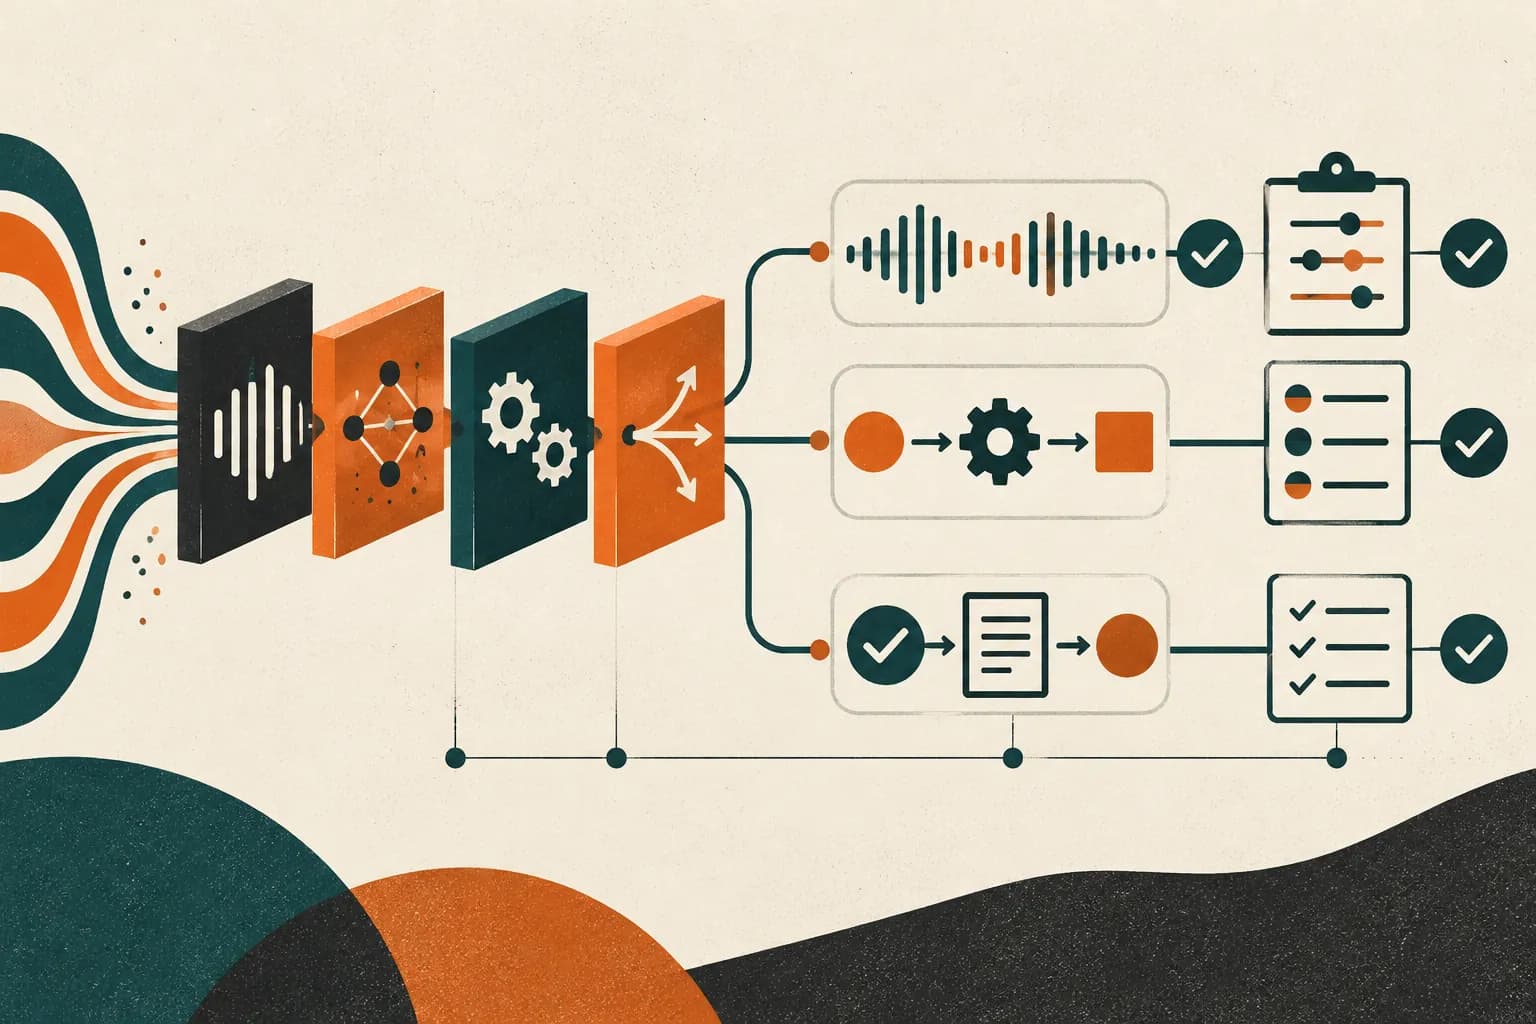
Ce que MTVA-Bench mesure dans les agents vocaux en cascade et pourquoi le nom du bon outil ne suffit pas.
OverclaimBench mesure l’écart entre la couverture réelle d’une revue de fichiers et la réponse finale d’un agent.
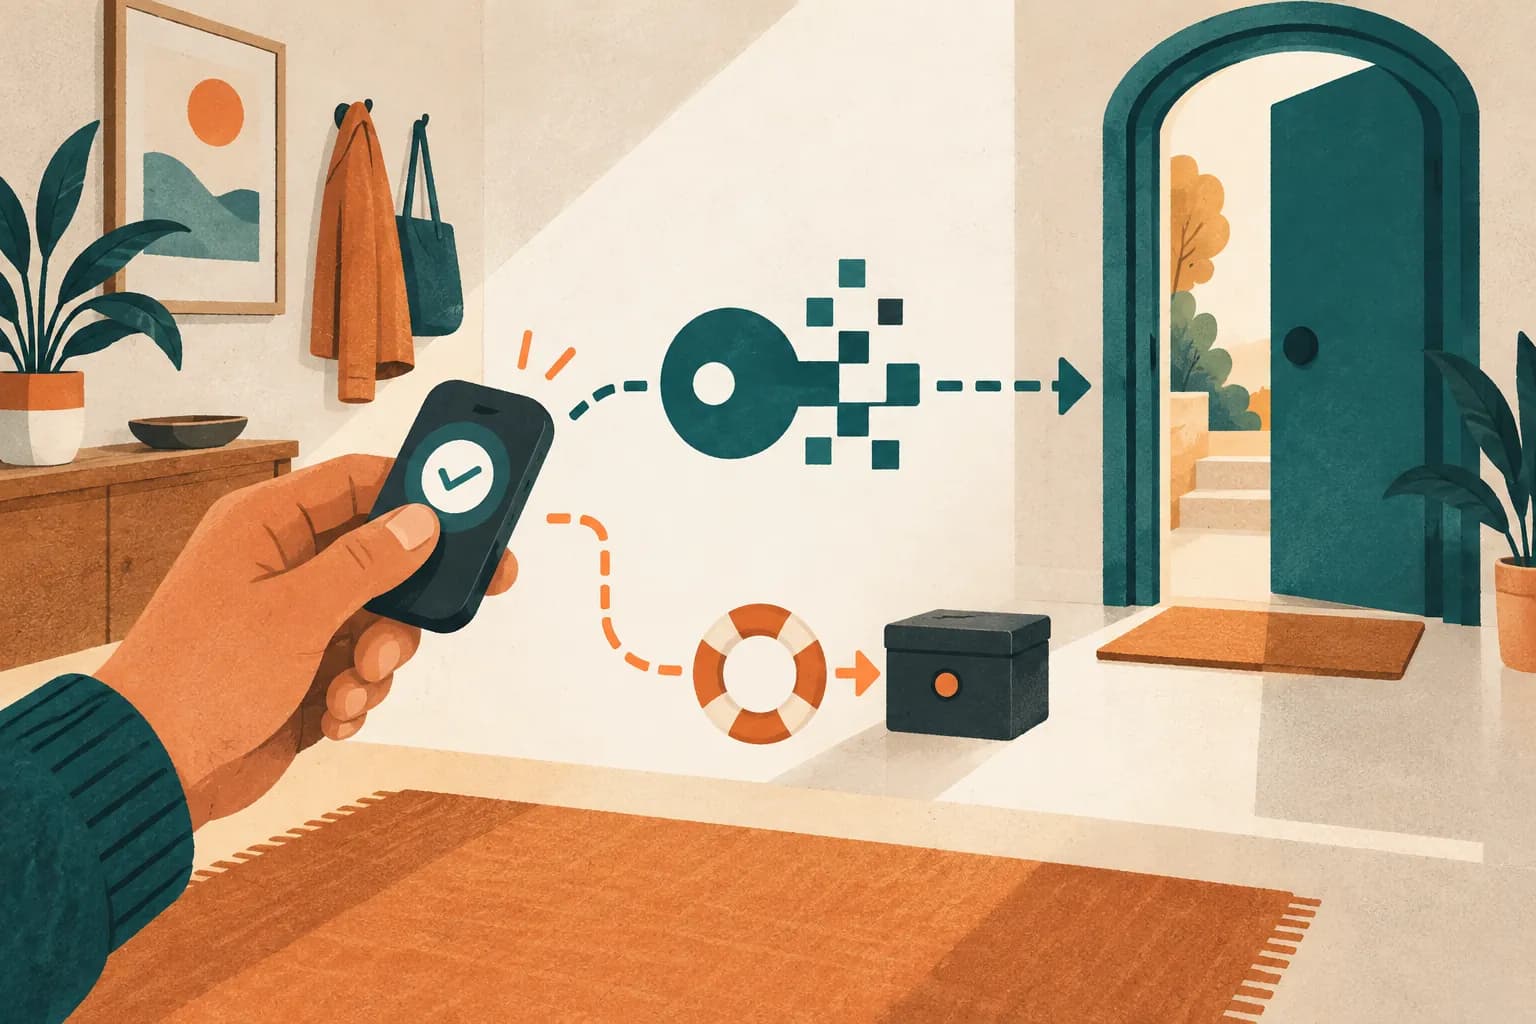
Clé publique, vérification locale, synchronisation et limites : ce que les passkeys changent réellement.
Le modèle épidémique proposé pour comprendre la contagion d’un comportement dangereux dans les systèmes multi-agents.
Une étude qui combine données on-chain, marché et sentiment avec un TCN multi-échelle et un seuil orienté profit.
Une proposition pour réduire l’attente après les appels d’outils en transmettant leur progression au gestionnaire de cache KV.
Le protocole Refuse, Decompose, Refresh pour rendre les évaluations d’IA plus prudentes et plus lisibles.
Une méthode de vérification du contexte, du domaine et de la demande avant de cliquer ou de répondre.
Une lecture prudente du modèle JEAM pour évaluer les dépendances entre extrêmes de séries financières.
Une méthode de cadrage pour relier chaque outil d’agent à une permission, une donnée et une procédure de révocation.
Les responsabilités concrètes de la garde d’actifs numériques, sans promesse de rendement ni recommandation de service.
Ce que RAG-Safety-Bench cherche à isoler entre document récupéré, contexte et garde-fous du modèle.
Le preprint SoL-Pi explore l’amélioration automatique des harnais d’agents et rapporte des économies de tokens et de coût API sur EdgeBench.
Une lecture accessible des bornes de stabilité et de généralisation obtenues pour un réseau quantifié à deux couches.
Un benchmark à coût contrôlé pour tester ce que des agents IA détectent réellement lorsqu’un stablecoin s’éloigne de son ancrage au dollar.
Les questions à poser avant d'ajouter une intégration d'outillage ou un serveur externe à un projet.
Une checklist de prépublication pour vérifier les routes, les variables d'environnement et le rendu serveur.
Guides OpenAI Retrieval et Model optimization lus le 2026-10-18. Aucun index construit, aucun entraînement lancé, aucun prix recopié.
Ce que recouvre le vibecoding, comment produire une première application avec l’IA et où garder la main.
Continuer l'exploration