
Article · IA & agents
OPTED : distiller un enseignant privilégié pour la conduite autonome
Une stratégie de fine-tuning en boucle fermée qui réduit le coût d’exploration d’une politique caméra.
Le problème de la boucle fermée
Une politique de conduite apprise sur des démonstrations humaines peut sortir de la distribution dès qu’elle agit dans une simulation ou sur une route. Le renforcement direct d’une politique caméra est coûteux, car chaque interaction demande une simulation sensorielle.
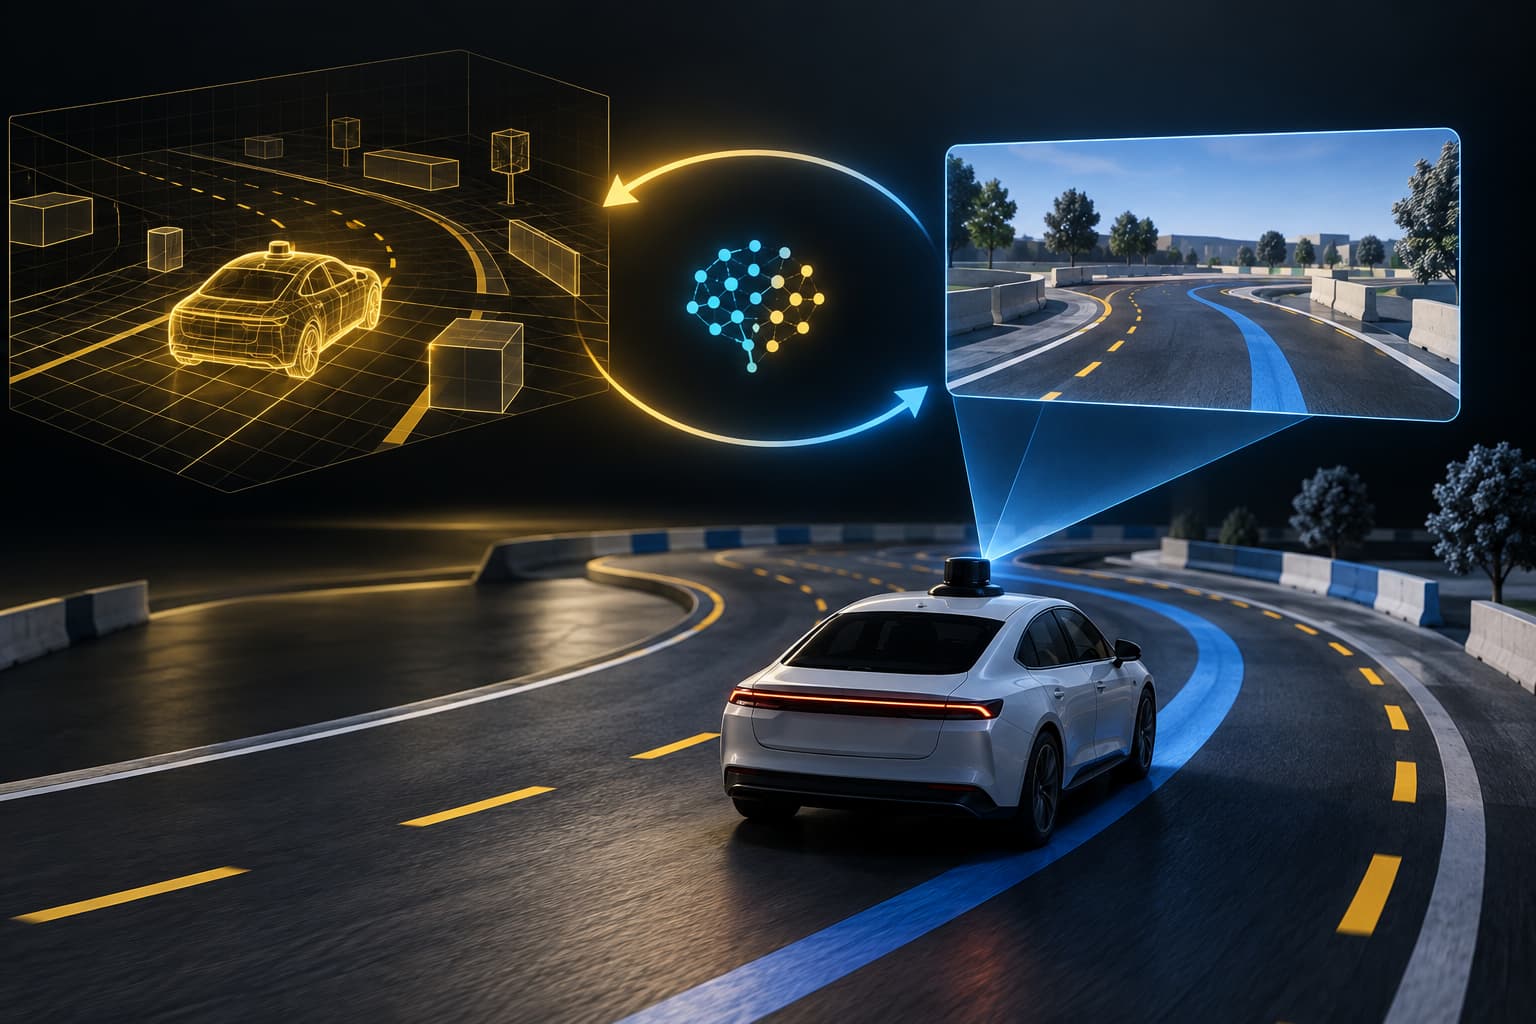
OPTED sépare ces rôles. Un enseignant reçoit des entrées vectorielles privilégiées, comme une carte HD et des boîtes englobantes, puis est entraîné avec du RL. Il produit un futur plan avec une dynamique de modèle bicyclette. Il supervise ensuite une politique étudiante préentraînée sur les images dans une boucle fermée ; les trajectoires récentes sont conservées dans un tampon FIFO borné, et la perte suit la sortie de l’étudiant (KL pour une distribution d’actions, régression L1 pour des waypoints).
Les résultats rapportés
Les auteurs appliquent la méthode à TransFuser et VaVAM dans AlpaSim, avec des reconstructions neurales 3DGS de journaux de conduite. Sur le split public NuRec, le score de scène passe de 26,5 à 41,8 pour LTFv6 et de 3,9 à 37,1 pour VaVAM à budget égal ; sur le challenge privé, il passe respectivement de 25,1 à 32,2 et de 6,7 à 35,8. Le résumé rapporte ainsi une hausse des scores de conduite par des facteurs de 1,6 et 9,5 selon le modèle.
Dans l’expérience vectorisée sur WOMD, OPTED atteint 95 % du score de l’enseignant après environ 6 800 épisodes fermés, contre 6,2 millions pour le fine-tuning RL direct dans la comparaison annoncée. Les deux approches ne poursuivent pas exactement le même compromis : l’OPTED reste une distillation tandis que le RL direct optimise la récompense.
Ce que la distillation ne résout pas
Le papier montre aussi l’importance du contrôleur et des variables observées. Pour VaVAM, l’absence de vitesse du véhicule et la rareté des scènes rapides dans le préentraînement créent des erreurs à haute vitesse. Une contrainte de cercle de friction dans le contrôleur réduit les sorties de route dans l’expérience décrite.
Limites
Ces résultats sont obtenus dans des environnements simulés et des protocoles définis. Une réduction du nombre d’interactions ne constitue pas une preuve de sécurité sur route ouverte. Il faut tester les capteurs, les contrôleurs, les scénarios rares et les conditions hors distribution séparément.
Sources
Damiano Da Col et coauteurs, « OPTED: On-Policy Fine-Tuning for End-to-End Driving using a Render-Free Teacher », ArXiv 2609.20756v1, consulté le 22 septembre 2026 : résumé et preprint, PDF.