
Article · IA & agents
Évaluer hors ligne une politique avec un bootstrap du modèle
Une méthode de bootstrap régénère des trajectoires depuis un MDP estimé pour quantifier l’incertitude d’une évaluation RL.
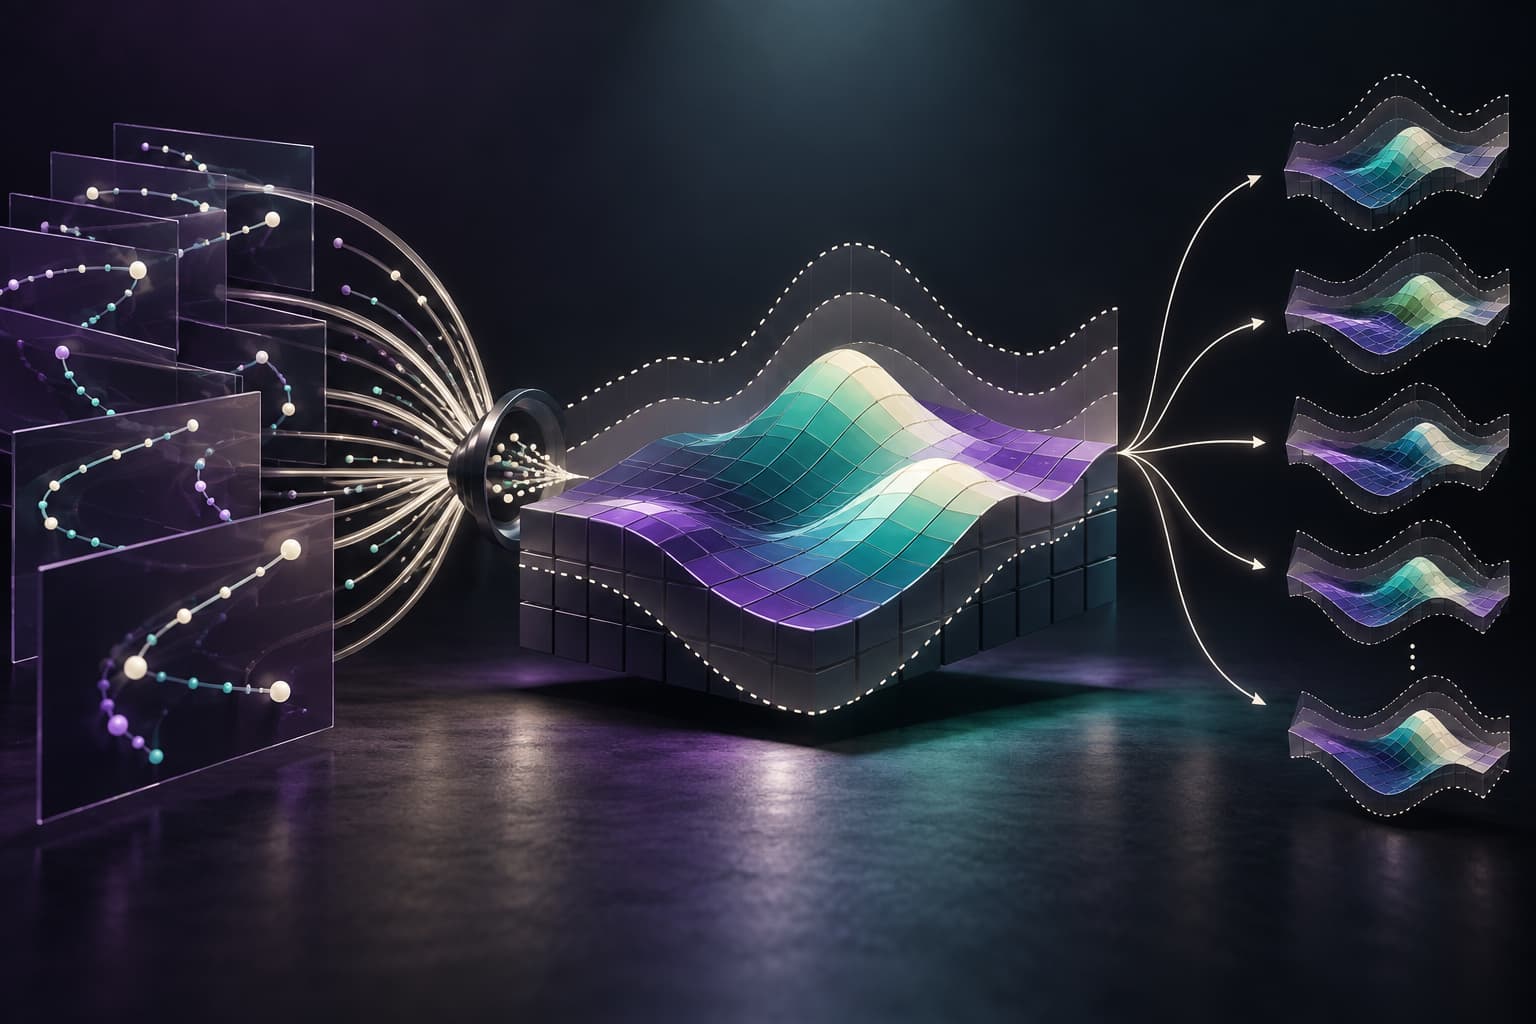
Un score ne suffit pas
En apprentissage par renforcement hors ligne, une nouvelle politique doit être évaluée avant de toucher un environnement réel. Une estimation ponctuelle de sa valeur peut sembler meilleure simplement à cause du bruit d’échantillonnage. Dans un contexte à risque, il faut aussi une variance et un intervalle de confiance qui reflètent la distribution de l’erreur d’évaluation.
Rejouer un MDP estimé
Le papier propose un bootstrap fondé sur le modèle pour des MDP tabulaires, à horizon fini et éventuellement non homogènes dans le temps. Au lieu de rééchantillonner uniquement des épisodes complets, il estime les transitions et les récompenses puis régénère des trajectoires depuis le MDP obtenu.
Cette construction accepte des formats de données plus variés : trajectoires complètes, observations de transitions et fragments de trajectoires. Elle conserve la dépendance temporelle nécessaire à l’évaluation et peut exploiter davantage d’information qu’un bootstrap d’épisodes lorsque le jeu hors ligne est fragmenté.
Des garanties pour l’incertitude
Les auteurs établissent la consistance distributionnelle du bootstrap, la validité asymptotique des intervalles et la consistance de l’estimation de variance pour la valeur de la politique cible. Les simulations montrent que la distribution reconstruite suit l’erreur d’évaluation et produit, dans la plupart des configurations étudiées, des intervalles plus serrés et des variances plus précises.
Le résultat déplace le débat : la question n’est pas seulement « quelle politique a le meilleur score ? », mais aussi « quelle incertitude accompagne cette différence ? ». Un intervalle qui recouvre largement les deux valeurs appelle une décision différente d’un gain ponctuel apparemment net.
Limites
Le cadre est tabulaire, à horizon fini et dépend d’hypothèses de couverture et d’estimation du MDP. Un modèle mal spécifié ou des actions rarement observées peuvent produire une incertitude mal calibrée, même si le bootstrap est cohérent sous ses hypothèses. Les validations sont simulées et ne démontrent pas une validité uniforme pour des MDP continus, des horizons très longs ou des données fortement corrélées.
Sources
Weiwei Wang, Yuqiang Li, Xianyi Wu et Bingyi Jing, « Model-based Bootstrap for Offline Policy Evaluation in Tabular Reinforcement Learning », ArXiv 2609.20389v1, consulté le 22 septembre 2026 : résumé et preprint, PDF.