
Guide · SaaS & dev
Construire une couche sémantique sur des événements : un atelier de validation
Un atelier sans déploiement pour passer d’événements techniques à des étapes métier, inspiré d’une induction hiérarchique par LLM et RAG.
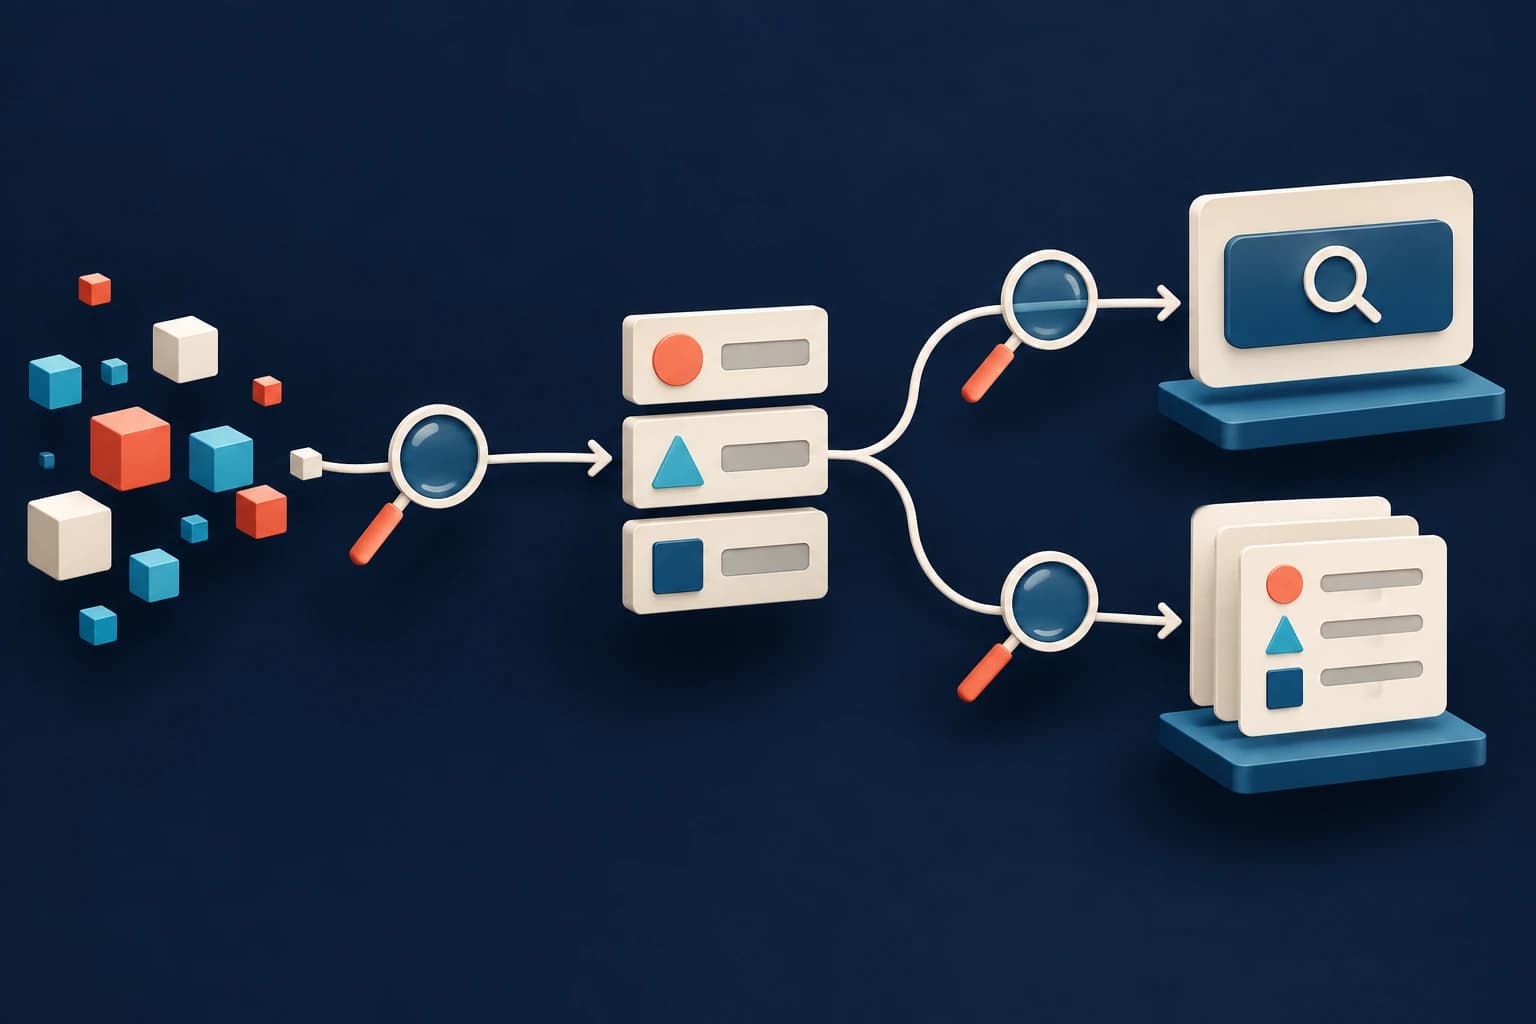
Le problème : un événement technique ne décrit pas toujours une action métier
Le preprint étudié propose d’induire une couche sémantique à partir de télémétrie applicative. Le résultat recherché est une hiérarchie reliant des fonctions métier, des étapes précises et des règles de correspondance avec les événements. Une simple liste de noms d’événements ne suffit pas lorsque la signification dépend d’un attribut.
L’atelier ci-dessous est une adaptation pédagogique. Il utilise des événements fictifs et ne reproduit pas les expériences du papier.
Étape 1 — Préparer un petit échantillon vérifiable
Constituer une dizaine de lignes comprenant un nom d’événement et des attributs, par exemple un type de page ou une action. Ajouter volontairement deux valeurs équivalentes écrites différemment. Écrire à la main le sens attendu avant toute proposition automatisée.
Dans le papier, la préparation repose sur l’importance des colonnes et la normalisation des énumérations. Pour cet atelier, le livrable est une table « valeur brute → valeur normalisée », avec une justification. Ne pas fusionner des valeurs simplement parce que leurs noms se ressemblent.
Étape 2 — Séparer la fonction de son étape
Choisir une fonction, comme la recherche. Distinguer ensuite « lancer une recherche » et « consulter les résultats ». Le système étudié identifie des fonctions à partir d’un échantillon stratifié et de références métier, puis regroupe les règles correspondant à une même étape.
Sur vos lignes fictives, attribuer chaque événement à une étape ou à une case « ambigu ». Cette dernière évite de transformer une absence de contexte en certitude.
Étape 3 — Évaluer les conditions proposées
Le papier indexe des conditions attribut-valeur, plutôt que des événements entiers. La recherche de candidats est suivie d’un filtre explicite puis d’un jugement sémantique. Préparer pour chaque règle deux exemples qui doivent correspondre et un contre-exemple.
Une règle sur le titre d’une page peut reconnaître un résultat de recherche tout en capturant une page d’aide sans rapport. Le contre-exemple permet de détecter cette confusion avant de la convertir en indicateur métier.
Étape 4 — Vérifier séparément la structure et le sens
La sortie décrite est un objet JSON associant un identifiant de nœud, un nom, des conditions et des métadonnées. Un JSON correctement parsé ne prouve pas que les conditions sont justes. De même, une température fixée à zéro ne constitue pas à elle seule une preuve d’exactitude.
Le contrôle final de l’atelier consiste à rejouer les règles sur l’échantillon et à expliquer chaque correspondance. Conserver les cas ambigus pour revue au lieu de les compter automatiquement.
Résultats et limites du point de départ
Sur 100 correspondances évaluées par cinq experts, les auteurs rapportent un score moyen de 82,3 contre 51,6 pour la référence. Leur corpus provient d’un commerce en ligne sur six mois ; ce résultat ne garantit pas la même qualité dans une autre application. Les ablations soutiennent l’importance des étapes, mais l’extraction locale comporte des coupures. Aucun gain de temps ou de couverture n’est promis par cet atelier.
Source et statut
Source principale : Semantic Layer Induction from Raw Telemetry via Hierarchical LLM and RAG Abstraction, prépublication ArXiv 2609.19615v1 · PDF. Les résultats rapportés sont ceux des auteurs ; les conseils de méthode sont une interprétation éditoriale. Publication éditoriale, sans reproduction expérimentale dans cette session.
Compléments officiels effectivement consultés : 5 Conclusion · 4.4 Manual Effort Reduction. Lecture partielle ; voir les passages et limites consignés dans la frontmatter.