
Guide · IA & agents
RegRet : rechercher une région d’image sans perdre le contexte utile
Construire une évaluation qui distingue identité de l’objet, contexte de scène et modalité de recherche à partir de RegRet et REGMB.
Définir ce qui rend le résultat correct
Une recherche portant sur un objet dans une image peut vouloir retrouver le même objet ou une scène qui satisfait aussi une contrainte de contexte. Ces deux tâches ne se jugent pas de la même façon.
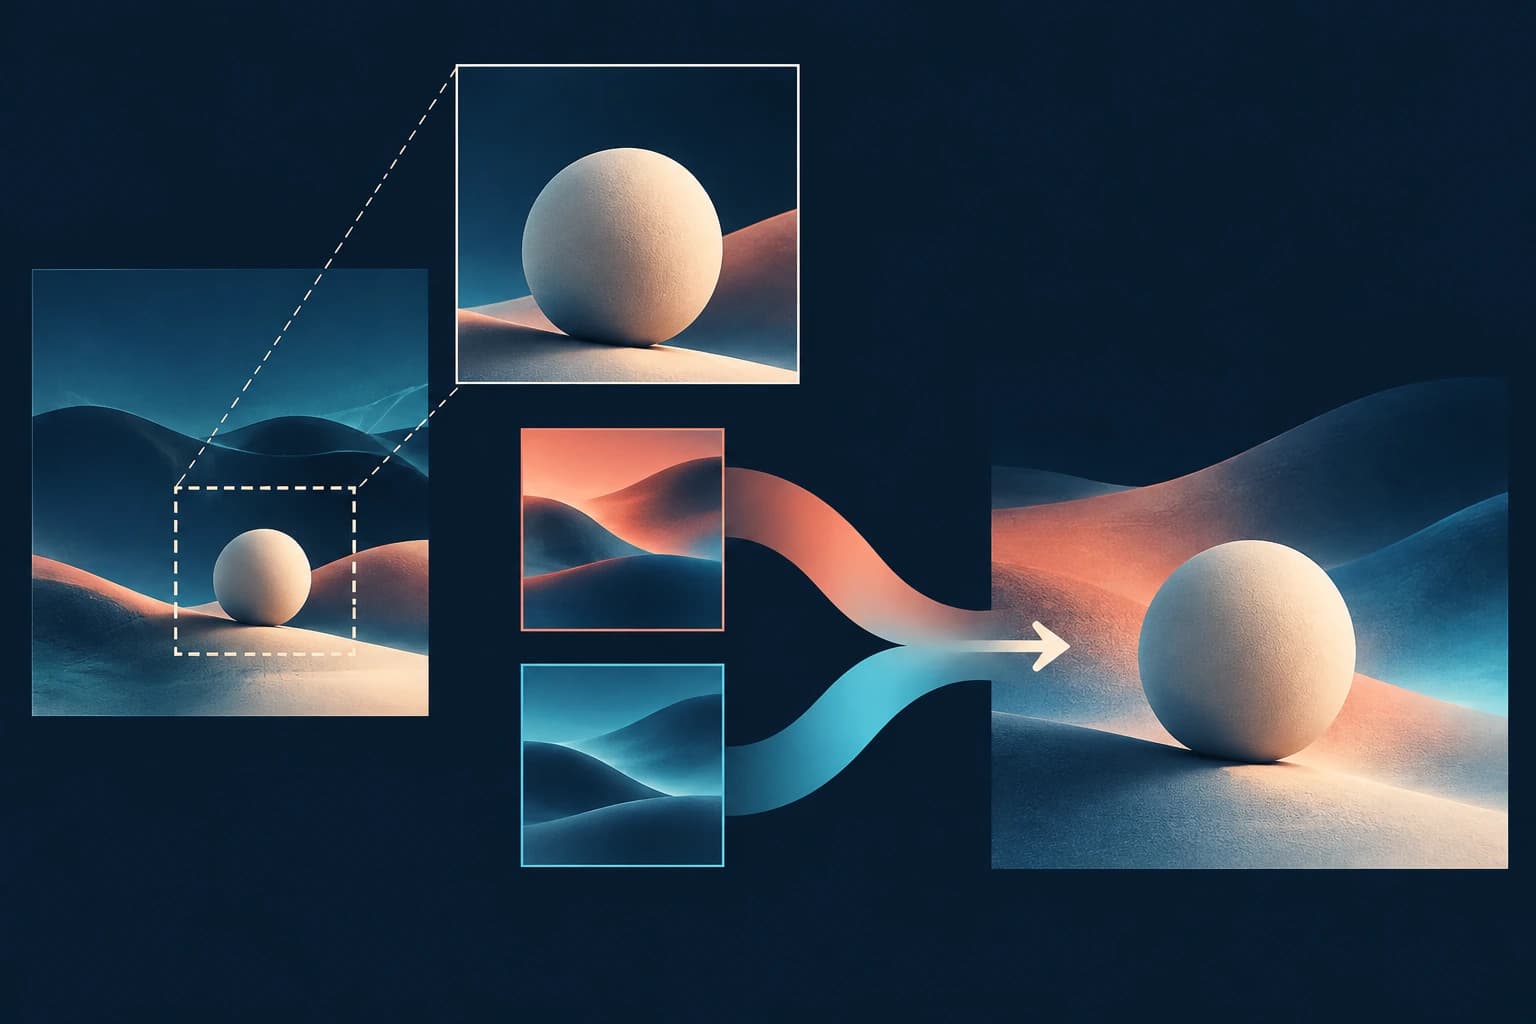
RegRet propose un encodeur qui équilibre représentation de la région et information de l’arrière-plan. Le papier explique les limites des approches simples : un recadrage peut supprimer un indice utile, tandis qu’une image entière peut laisser le fond dominer la représentation.
Construire deux familles de cas
Pour une évaluation, séparer les requêtes où l’objet suffit de celles où le contexte est indispensable. Dans la seconde famille, plusieurs images peuvent contenir le bon objet, mais une seule avoir l’environnement demandé.
Le benchmark REGMB distingue précisément recherche au niveau de la région et recherche dépendante du contexte. Il comprend 200 000 paires d’entraînement et 25 000 de test, issues de plusieurs sources et de différents types d’annotation.
Comparer des entrées réellement comparables
Définir si la région d’intérêt existe dans la requête, dans les candidats ou dans les deux. Une méthode disposant d’un encadré précis dans les candidats ne résout pas exactement le même problème qu’un moteur recevant uniquement des images entières.
Le papier évalue également un corpus où seules les requêtes disposent de régions. Cette précision doit accompagner les scores : elle renseigne le travail de localisation implicitement fourni au modèle.
Auditer les annotations et les contre-exemples
REGMB combine des légendes produites par des modèles, des annotations humaines et des paires comportant des variations de scène ou des modifications d’image. Le type de supervision influe sur ce qu’un résultat mesure.
Dans un jeu maison, conserver des contre-exemples proches : même objet dans un autre contexte, autre objet dans un fond similaire, changement d’éclairage ou de posture. Vérifier manuellement qu’une contrainte textuelle distingue effectivement la cible.
Interpréter les gains avec prudence
Les résultats rapportés favorisent RegRet sur les benchmarks étudiés. Une moyenne peut toutefois réunir des tâches, tailles de candidats et métriques différentes. Les tables officielles utilisent notamment R@1, R@5 et différentes variantes de précision moyenne ; les colonnes doivent être lues avant de comparer les nombres.
Le papier présente la recherche de documents visuels et l’intégration au RAG comme des pistes futures. Elles ne sont donc pas des capacités démontrées par cette étude. Ce guide propose un protocole d’évaluation, sans modèle installé ni expérience exécutée, à partir des passages locaux et de la section officielle REGMB.
Source et statut
Source principale : RegRet: Enhancing Region-Level Retrieval in Large Multimodal Models, prépublication ArXiv 2609.16847v1 · PDF. Les résultats rapportés sont ceux des auteurs ; les conseils de méthode sont une interprétation éditoriale. Publication éditoriale, sans reproduction expérimentale dans cette session.
Compléments officiels effectivement consultés : 4 REGMB: A Region-Level Multimodal Retrieval Benchmark. Lecture partielle ; voir les passages et limites consignés dans la frontmatter.