
Guide · IA & agents
LSREP : tester une mémoire qui évolue sans confondre répétitions et utilisateurs
Une fiche pour déclarer l’état, les références temporelles et les effets des requêtes dans une évaluation de mémoire conversationnelle.
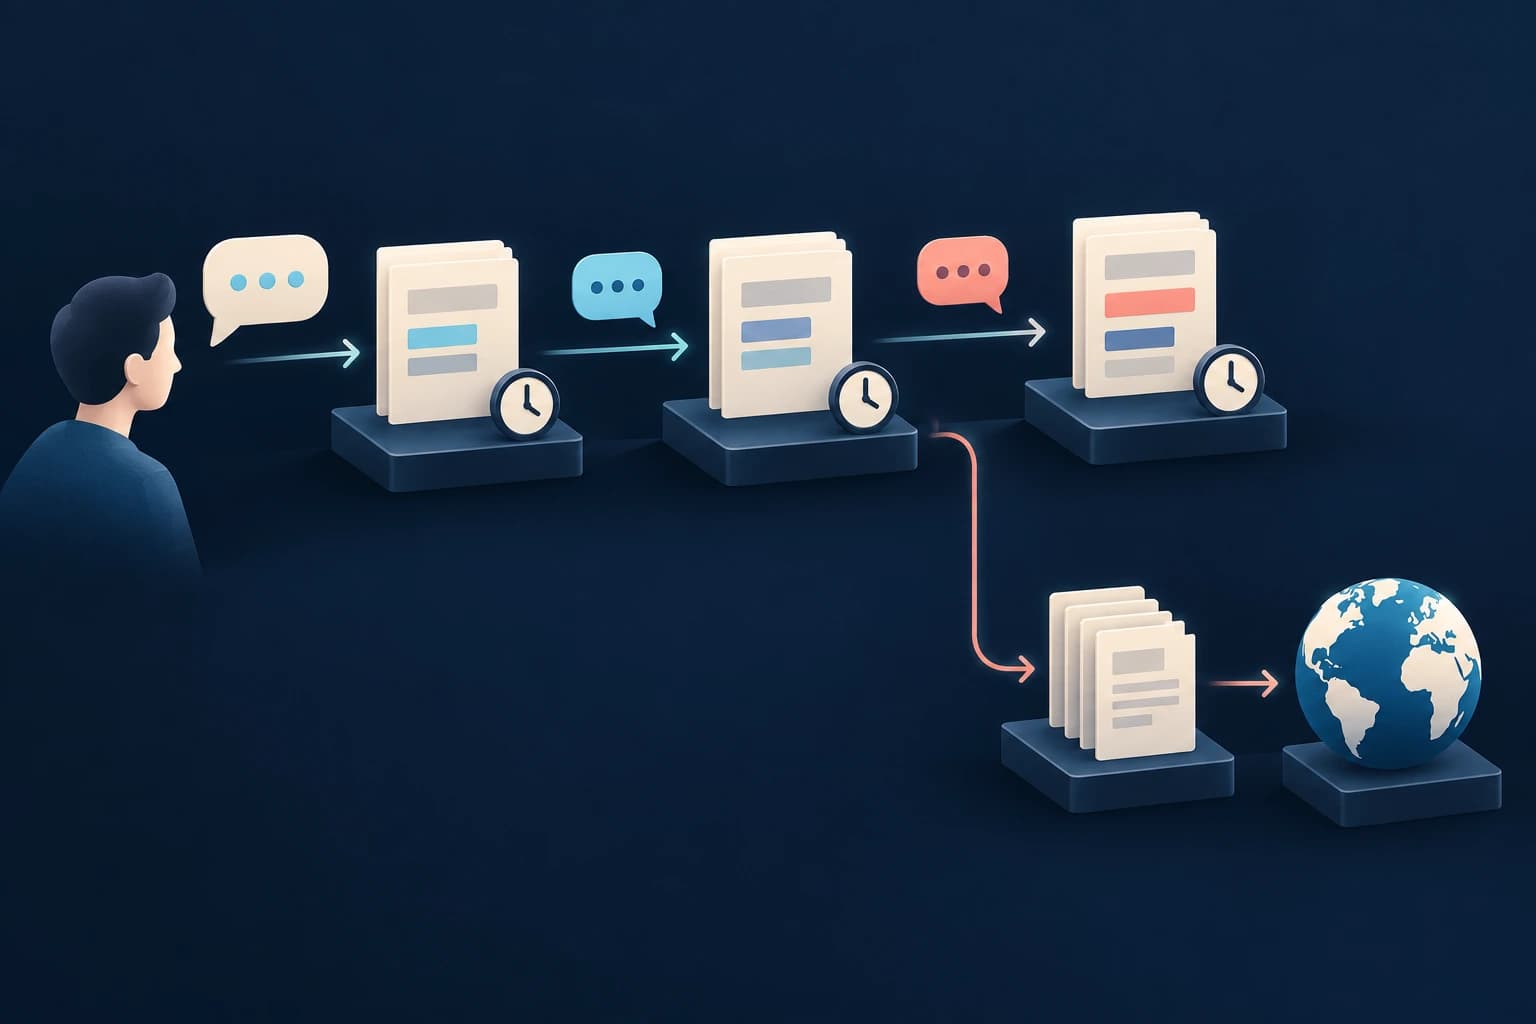
Ce que l’on rejoue
LSREP propose d’évaluer une trajectoire reconstruite de mémoire conversationnelle. Le protocole ne prétend pas retrouver exactement un déploiement historique dont les états n’auraient pas été enregistrés.
L’objet testé comprend l’ingestion, la maintenance, le vieillissement et les effets éventuels des requêtes. Une simple interface de conversation est insuffisante : il faut pouvoir déclarer l’état initial, les transitions et les conditions d’observation.
Fixer la référence au bon moment
À chaque point de contrôle, seules les informations déjà disponibles peuvent entrer dans la mémoire et dans la réponse de référence. Une question ancienne peut recevoir une référence actualisée, mais son objet et la provenance de la preuve doivent rester traçables.
Une fiche de replay doit donc consigner historique ingéré, version de référence, maintenance effectuée, contexte réellement transmis et état après interrogation. C’est une adaptation pratique des exigences du papier, sans exécution du système ICE dans cette session.
Déclarer si le test change la mémoire
Dans ICE v2, les accès d’évaluation renforcent la mémoire. La fréquence et l’ordre des questions participent donc à la trajectoire future. Le dispositif historique partage aussi un état stocké entre certaines conditions, au lieu de maintenir des trajectoires complètement indépendantes.
Cette distinction interdit de lire les comparaisons comme des expériences à états indépendants si ce n’est pas leur contrat. De même, un horizon simulé de vieillissement n’est pas une durée réellement passée en production.
Compter les unités indépendantes
Les quatre jeux privés viennent d’un seul auteur. Les 1 211 observations répètent 219 questions ; elles ne correspondent pas à 1 211 utilisateurs indépendants. Les auteurs reconnaissent que ces données ne permettent pas une généralisation à une population.
Ils rapportent également un transfert défavorable d’ICE v2 face à un RAG vectoriel dans leurs essais LongMemEval. Les juges et configurations diffèrent d’autres résultats publiés : ces nombres ne forment pas un classement officiel.
Auditer les composants avant d’attribuer un gain
La section des limites mentionne des composants défectueux ou non exercés. La présence d’une sortie de graphe ne démontre ni sa vérité ni son utilité. Une baisse de tokens associée à une baisse de précision n’établit pas non plus une meilleure efficacité.
Le livrable utile d’un tel test est un contrat de replay accompagné d’une trace d’exécution et d’une comparaison à budget ou qualité explicitement fixés. Les passages locaux ont été complétés par la section officielle des limites ; la lecture reste ciblée et n’atteste aucune performance d’une version ultérieure d’ICE.
Source et statut
Source principale : LSREP: A Longitudinal State-Replay Protocol for Evaluating Conversational Memory, with ICE v2 as an Audited Local-First Architecture, prépublication ArXiv 2609.16730v1 · PDF. Les résultats rapportés sont ceux des auteurs ; les conseils de méthode sont une interprétation éditoriale. Publication éditoriale, sans reproduction expérimentale dans cette session.
Compléments officiels effectivement consultés : 8 Limitations and Implications. Lecture partielle ; voir les passages et limites consignés dans la frontmatter.