
Guide · IA & agents
Transformer un incident d’agent en test de régression avec le replay sélectif
Une méthode de lecture de Chronicle pour rejouer les points de décision d’un agent sans exécuter à nouveau toutes ses frontières.
Le problème des agents non déterministes
Un test classique peut rejouer les mêmes entrées et comparer les sorties. Un agent LLM ajoute plusieurs sources de variation : la réponse du modèle n’est pas bit à bit reproductible, les outils consultent un état qui évolue et la trajectoire dépend des décisions prises aux tours précédents. Relancer un incident ne garantit donc pas de retrouver le même chemin.
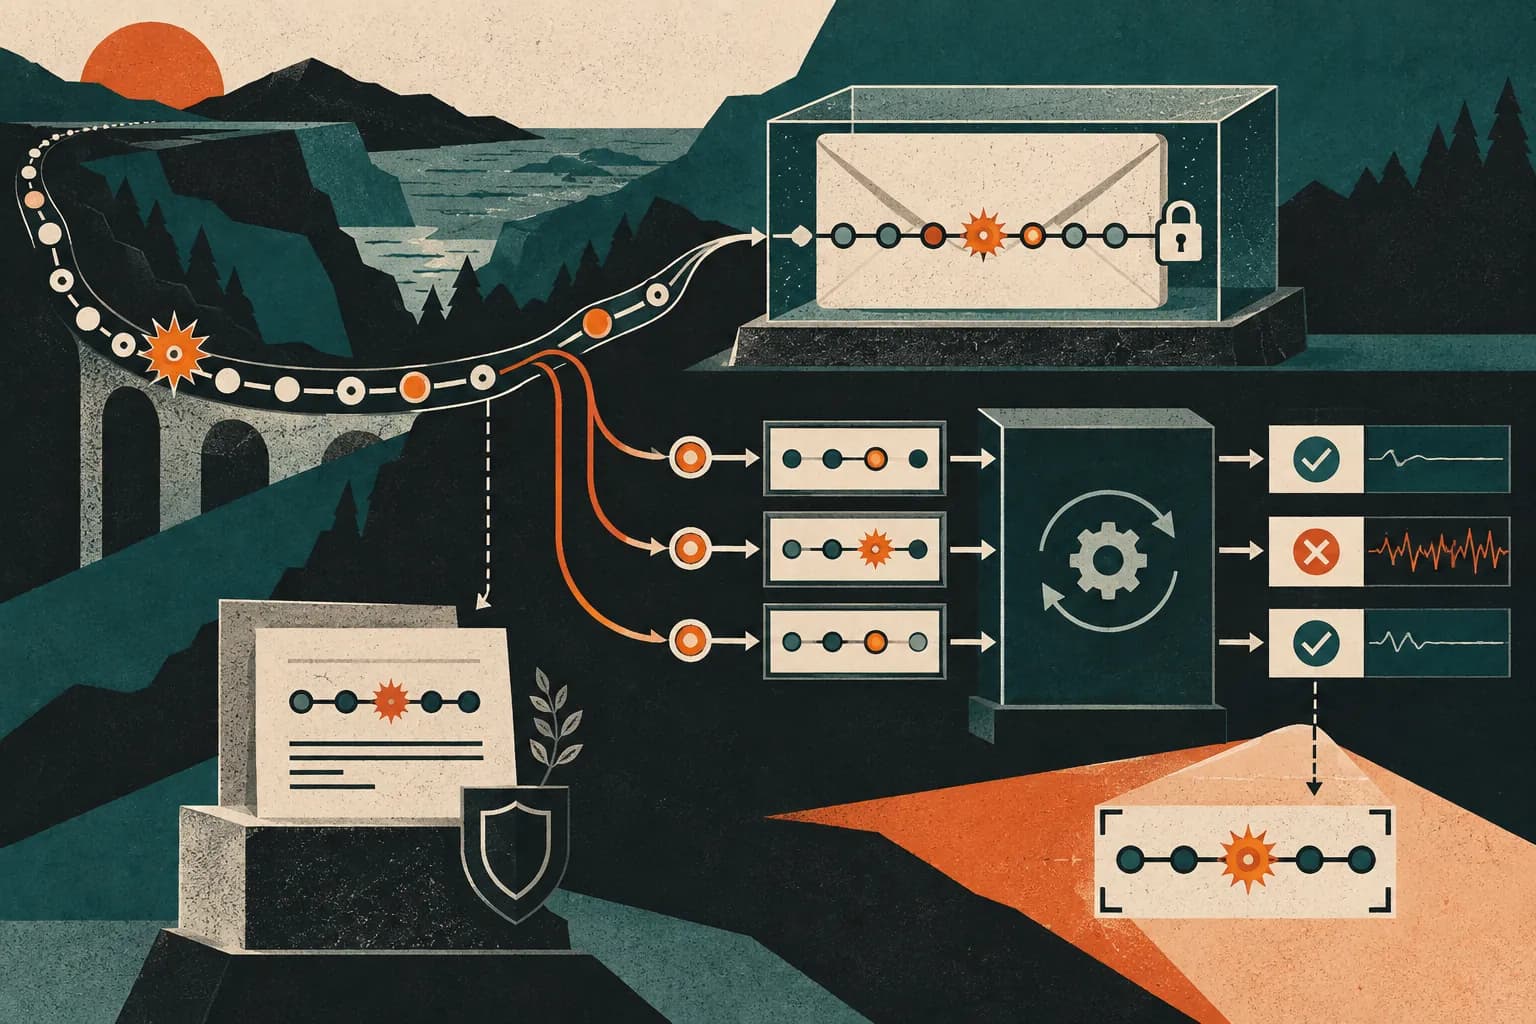
Le replay complet traite une partie de ce problème, mais il peut coûter cher et ne permet pas toujours d’isoler la frontière fautive. Le preprint Chronicle propose de conserver les points où la trajectoire devient non déterministe, puis de choisir lesquels seront rejoués depuis l’enregistrement et lesquels seront exécutés avec le nouveau code.
Le principe du cut-point replay
Chronicle enregistre un run aux frontières non déterministes sous forme d’enveloppes immuables. Une frontière peut correspondre à un appel modèle, à une réponse d’outil ou à un autre passage dont la sortie influence la suite. Lors d’un test, une partie des réponses vient de l’enregistrement. La partie complémentaire est recalculée avec la version du code que l’on veut vérifier.
Ce mécanisme transforme un incident documenté en test de régression. Il ne prétend pas rendre tout l’agent déterministe. Il fixe plutôt une portion de sa trajectoire afin de rendre observable l’effet d’une modification. Cette distinction est importante : un replay qui sert toutes les réponses peut vérifier la stabilité de l’infrastructure, mais il n’exerce plus les composants dont les sorties sont remplacées.
Une procédure prudente
Commencez par choisir un incident dont l’échec est compris. Enregistrez les entrées et sorties nécessaires, sans capturer de secrets ou de données personnelles sans politique de rétention. Notez la condition qui caractérise l’échec : action interdite, argument incorrect, permission oubliée ou réponse finale contradictoire.
Ensuite, choisissez le point de coupure. Si l’objectif est de tester un garde-fou d’outil, il peut être utile de rejouer la décision modèle et de recalculer l’autorisation. Si l’objectif est de tester une nouvelle stratégie de planification, le test doit laisser cette stratégie s’exécuter et stabiliser seulement les dépendances périphériques. Chaque frontière fixée réduit la surface testée ; chaque frontière recalculée augmente la variabilité.
Enfin, comparez l’état atteint et non seulement le texte final. Un agent peut produire un message identique tout en ayant envoyé un argument différent. La trace doit donc rendre visibles les appels et les réponses intermédiaires.
Résultats rapportés
Le benchmark présenté contient six incidents enregistrés avec des frontières modèle simulées. L’enregistrement ajoute 23 microsecondes par passage, soit 0,008 % d’un appel modèle supposé durer 300 millisecondes. Un replay complet n’émet aucun appel modèle et reste bit-stable sur vingt répétitions. Les tests à points de coupure échouent sur le code fautif et passent sur les changements protégés et bénins pour les six incidents.
Une étude par mutations rapporte que les tests détectent chaque mutant qui laisse passer l’action dangereuse enregistrée. Un baseline qui remplace toutes les frontières, avec la même assertion, n’en détecte aucun. Le résultat illustre le compromis : un test doit laisser vivre la partie que l’on veut réellement exercer.
Intégration continue et gouvernance
Un incident de production ne devrait pas rester une capture dans un ticket. Une fois nettoyé et documenté, il peut devenir un test de non-régression. Le nom du test doit rappeler l’obligation métier, pas seulement le numéro de trace. La revue doit aussi préciser quelles réponses sont figées et lesquelles sont recalculées.
Cette démarche demande une gouvernance des enregistrements. Il faut limiter leur durée de conservation, supprimer les secrets, contrôler l’accès et prévoir l’invalidation lorsque le contrat d’un outil change. Un replay ancien peut devenir trompeur s’il représente un backend dont le schéma ou les permissions ont évolué.
Organiser un cas de replay
Un cas devrait commencer par une fiche courte : objectif de la tâche, version du harness, outils disponibles, données utilisées et comportement attendu. La fiche indique ensuite les frontières enregistrées et les frontières recalculées. Cette documentation permet à une autre personne de comprendre ce que le test exerce réellement sans relire toute la conversation.
Le test doit aussi décrire sa limite. Un replay qui stabilise la réponse d’un fournisseur ne vérifie pas le comportement du fournisseur. Un replay qui stabilise l’état d’un backend ne vérifie pas une migration de ce backend. Un test peut être utile tout en ayant une couverture étroite, à condition que cette couverture soit nommée.
Éviter les faux positifs
Un test de replay peut devenir trop strict si une sortie non pertinente est comparée au caractère près. Il peut aussi devenir trop permissif si seule une phrase finale est inspectée. Les assertions devraient porter sur l’obligation métier : un outil interdit n’est pas appelé, un argument reste dans son domaine, une confirmation est obtenue avant l’action.
Lorsque le contrat change volontairement, il est préférable de créer une nouvelle version du cas et de conserver l’ancienne comme historique. Modifier silencieusement l’enregistrement détruit l’information sur la régression qui avait été détectée. La traçabilité des versions est donc aussi importante que la vitesse du replay.
Quand ne pas utiliser le replay seul
Les incidents qui dépendent fortement du temps réel, de la concurrence ou d’un service externe doivent être complétés par des tests d’intégration. Le replay est adapté pour stabiliser une frontière et isoler un changement ; il ne remplace pas un contrôle de permissions en environnement contrôlé ni une vérification de reprise après incident. Une stratégie complète combine plusieurs niveaux de preuve.
Un exemple de décision
Imaginons qu’un agent ait envoyé une action interdite après avoir reçu une réponse ambiguë d’un outil. Le premier test peut figer la conversation et laisser le contrôle d’autorisation s’exécuter. Si le contrôle bloque correctement l’action, le test protège cette règle. Un second test peut laisser l’outil répondre en direct afin de vérifier que le parseur supporte encore son schéma courant. Les deux tests n’ont pas le même objectif et ne devraient pas être confondus.
Ce découpage permet de réduire le temps d’exécution sans prétendre couvrir l’ensemble de l’agent. Il rend aussi la revue plus claire : le premier cas protège une décision, le second une intégration. Lorsque l’un échoue, l’équipe sait quelle frontière examiner en premier.
Conserver la preuve de la revue
Chaque évolution d’un cas de replay devrait conserver la raison de la modification. Une assertion élargie peut rendre le test moins fragile, mais elle peut aussi masquer une régression. Une frontière supprimée peut accélérer le test, mais elle peut retirer précisément le composant qui avait échoué. Une courte note de revue aide à éviter ces changements silencieux.
Le replay sélectif est donc un outil de discipline autant qu’un outil de vitesse. Il pousse à nommer les frontières, les obligations et les limites de la preuve. C’est cette explicabilité qui lui donne une valeur durable dans une chaîne d’agents changeante.
Résumé opérationnel
En pratique, conservez une trace nettoyée, choisissez une frontière, écrivez une assertion métier et documentez ce qui reste hors couverture. Faites évoluer les cas par version et vérifiez qu’un changement volontaire ne réécrit pas l’historique. Le replay sélectif devient alors une brique de preuve parmi d’autres : rapide pour une régression ciblée, insuffisante lorsqu’elle est utilisée seule pour représenter tout un environnement.
Une équipe peut commencer avec un seul incident et élargir progressivement le catalogue. Chaque nouveau cas devrait apporter une couverture différente : permission, argument, état externe, arrêt prématuré ou compte rendu. Cette diversité est plus utile qu’un grand nombre de traces très proches. Elle réduit aussi le risque de croire qu’un agent est robuste parce qu’il réussit plusieurs variantes d’un même scénario.
Critères de sortie
Un cas peut être considéré comme prêt lorsqu’un lecteur sait ce qui est enregistré, ce qui est recalculé, quelle obligation est vérifiée et quelle limite demeure. Le résultat attendu doit être observable dans la trace. Si l’assertion dépend d’une impression générale, le cas risque de devenir instable ou de ne pas détecter une action incorrecte.
Il est utile de faire relire le cas par une personne qui n’a pas créé l’enregistrement. Si elle ne peut pas expliquer la frontière, l’obligation ou le résultat attendu, le cas manque probablement de contexte. Cette revue indépendante évite qu’un test ne devienne une boîte noire technique. Elle permet aussi de repérer les données sensibles qui auraient dû être supprimées avant stockage.
La revue peut se conclure par une fiche de maintenance : propriétaire du cas, version du contrat d’outil, conditions d’invalidation et date de la dernière exécution. Un cas ancien n’est pas inutile, mais il doit être identifié comme historique lorsque son environnement n’est plus représentatif.
Cette fiche doit rester proche du cas afin que sa limite ne soit pas perdue dans une documentation générale.
Elle peut être relue à chaque changement de modèle ou de contrat d’outil. Si le cas n’est plus pertinent, on le marque comme historique plutôt que de le réécrire sans trace.
Ce que l’étude ne prouve pas
Six incidents simulés ne suffisent pas à démontrer une couverture générale des agents. Le coût mesuré dépend du protocole et de l’appel modèle de référence. Le replay sélectif ne supprime pas les erreurs liées aux changements d’état externe qui ne sont pas enregistrés. Chronicle est présenté dans un preprint ArXiv, qui n’est pas nécessairement évalué par les pairs.
Sources
Tisha Chawla et Susheem Koul, « Chronicle: Cut-Point Replay for Regression Testing of LLM Agents », ArXiv 2609.20625v1, consulté le 21 septembre 2026 : résumé et preprint, PDF.