
Guide · SaaS & dev
AURA : une bonne hypothèse de correction doit encore survivre aux tests
AURA relie diagnostic de sessions et propositions de code, mais ses essais rappellent que la plausibilité d’un correctif ne prouve pas son efficacité.
Faire de la preuve le livrable du diagnostic
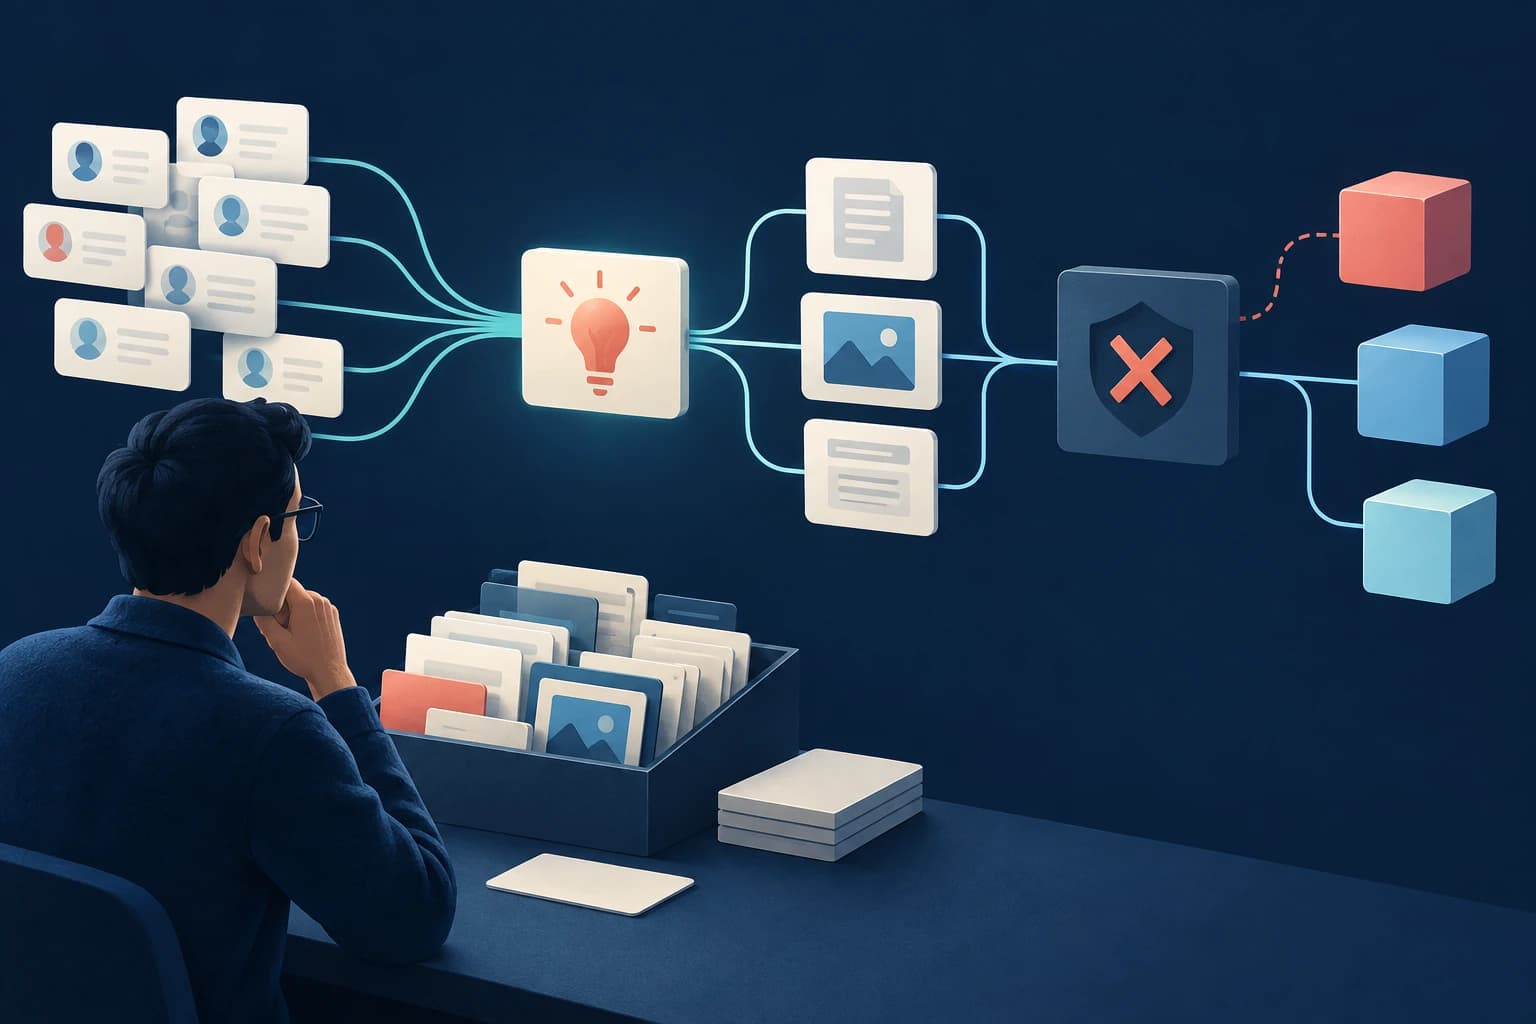
AURA organise l’analyse de sessions de recommandation en plusieurs étapes : sélection, diagnostic, proposition technique et préparation de correction. L’agrégation hiérarchique permet de traiter un grand volume de sessions et de regrouper les problèmes proches.
L’intérêt documentaire est de relier chaque catégorie à des identifiants de sessions, à une gravité et à une hypothèse. Un texte convaincant n’est utile que si l’ingénieur peut retrouver les éléments qui le soutiennent.
Vérifier chaque frontière
Le papier décrit des contrôles programmatiques des identifiants, des sorties structurées et des chemins de fichiers. Une erreur initiale avait produit 904 identifiants de sessions inventés ; les contrôles ultérieurs rejettent les références absentes de l’entrée.
Pour adapter cette pratique, ne pas valider seulement la forme JSON. Vérifier également l’appartenance des identifiants à l’ensemble autorisé et la résolution des références. Une valeur bien formée peut désigner un objet inexistant.
Chercher les données manquantes avant de réécrire le prompt
Une mauvaise calibration de la gravité provenait notamment de comptes et pourcentages non transmis. Le modèle devait les inférer. Les fournir explicitement a corrigé ce défaut dans les deux plateformes étudiées.
Cette observation motive une démarche simple : inspecter l’entrée réelle de chaque étape avant de conclure à un manque d’instructions. Une consigne ne remplace pas une donnée omise par l’architecture.
Une correction plausible peut rester sans effet
Le complément officiel est particulièrement utile : deux modifications proposées pour une catégorie de décalage de préférence de genre n’améliorent pas le classement sur la cohorte diagnostiquée de 1 911 sessions. Les écarts globaux restent dans le bruit des entraînements, autour de 0,1 %.
Les auteurs maintiennent donc ces changements comme candidats ouverts. Ce résultat empêche de confondre qualité du diagnostic, pertinence d’une hypothèse et bénéfice démontré de son implémentation.
Organiser la revue et la mémoire
Le dispositif présenté accède aux données analytiques en lecture seule et produit les modifications dans un dépôt isolé. Un humain nommé reste responsable de ce qui est livré. Les décisions de rejet ont leur place dans la mémoire des essais, au même titre que les propositions retenues.
Ces principes sont des enseignements de workflow, sans lancement d’AURA ici. La stabilité d’une taxonomie dépend aussi de sa disponibilité : le papier décrit une défaillance lors de sa perte. Les sections officielles sur le déploiement et la validation des corrections complètent la lecture locale ; aucun gain produit général n’est revendiqué.
Source et statut
Source principale : AURA: Agentic Diagnosis and Refinement for Production Recommender Systems at Scale, prépublication ArXiv 2609.16625v1 · PDF. Les résultats rapportés sont ceux des auteurs ; les conseils de méthode sont une interprétation éditoriale. Publication éditoriale, sans reproduction expérimentale dans cette session.
Compléments officiels effectivement consultés : 5 Deployment and Lessons · Closed-loop fix validation.. Lecture partielle ; voir les passages et limites consignés dans la frontmatter.