
Guide · IA & agents
Auditer la recherche web d’un agent, de la requête à la preuve citée
Un guide d’audit qui distingue appel au moteur, résultats consultés, citations et soutien réel des affirmations dans les réponses d’agents.
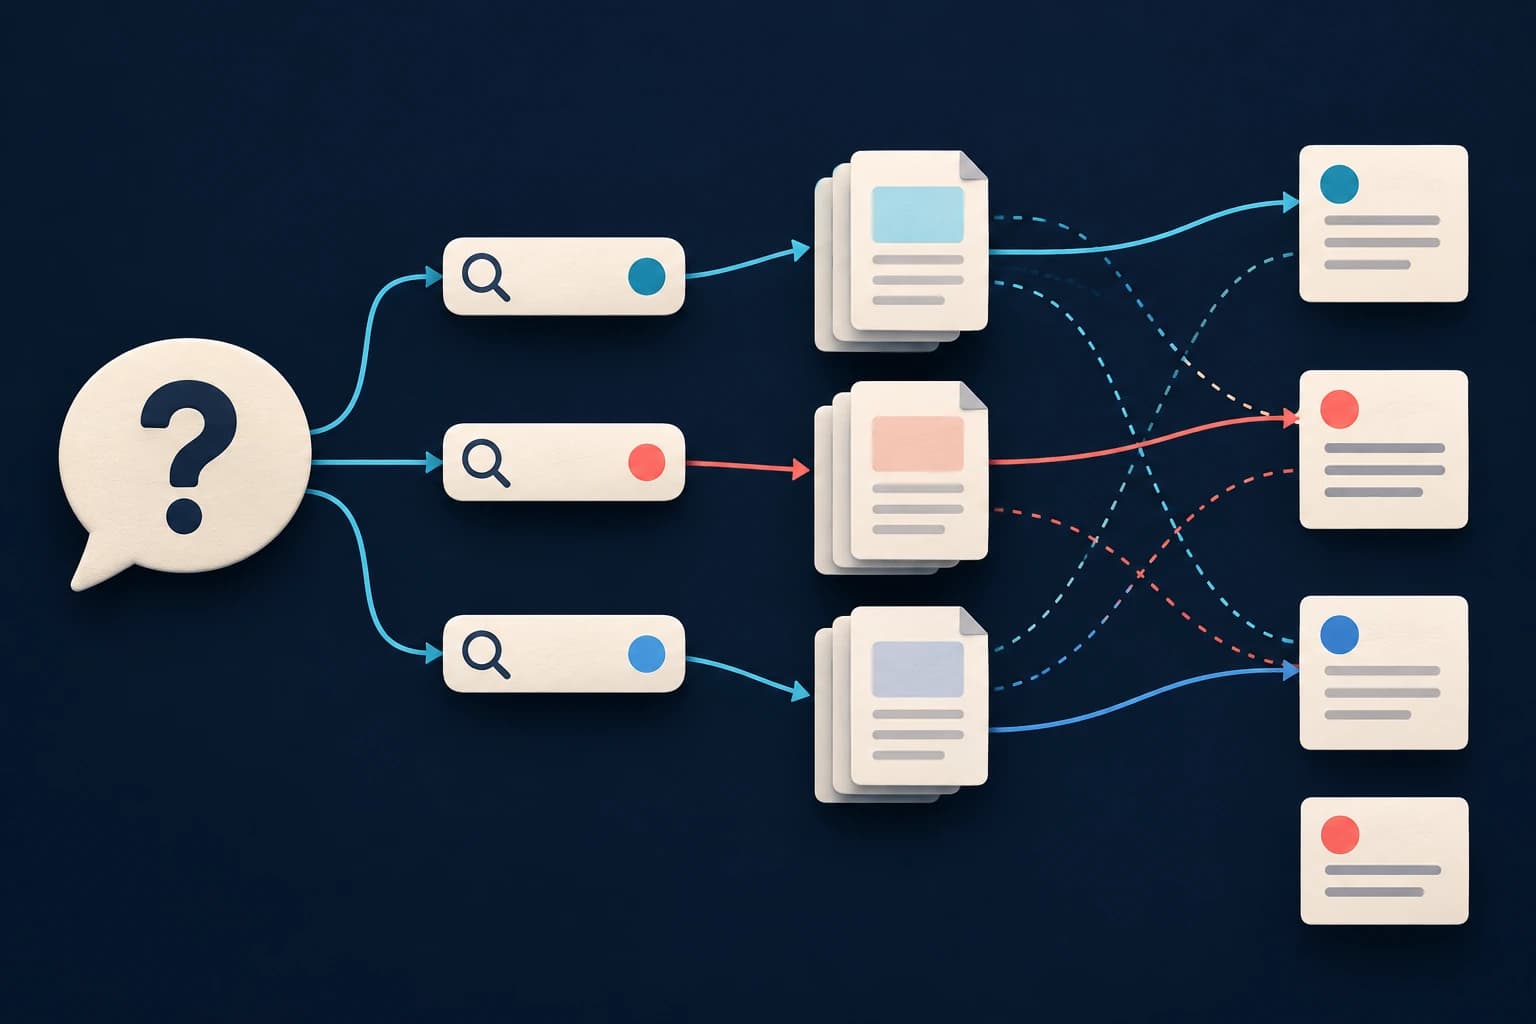
Un appel au moteur n’est que le début de la vérification
Le preprint sur la recherche web des agents conversationnels distingue plusieurs décisions : déclencher une recherche, formuler des requêtes, sélectionner des résultats et appuyer la réponse sur des sources. Un audit qui ne compte que les recherches ne voit pas les erreurs d’attribution à la fin de cette chaîne.
Les auteurs analysent 171 264 conversations données par 613 utilisateurs de quatre plateformes. Ils complètent cette observation par des expériences API sur 1 000 premiers messages identiques. Les interfaces grand public et les API constituent deux cadres différents ; leurs résultats ne doivent pas être fusionnés comme une mesure unique.
Construire une trace par affirmation
Pour un petit échantillon de réponses, conserver la question, les requêtes émises, les URLs retournées, les URLs citées et le texte final. Décomposer ensuite la réponse en affirmations suffisamment précises pour être confrontées à un passage.
Pour chacune, chercher d’abord le soutien dans la citation adjacente, puis dans les autres citations, puis dans les résultats non cités. Une dernière case recueille les affirmations pour lesquelles aucune preuve n’a été retrouvée. Ce classement est une méthode d’audit proposée ici à partir du protocole de l’étude ; il ne transforme pas automatiquement l’absence de soutien en fausseté.
Lire correctement le taux de citation
Dans le papier, le taux de citation est la fraction des URLs retournées par la recherche qui sont citées. Ce n’est pas la fraction des affirmations exactes. Citer peu de résultats peut être une sélection pertinente ; en citer beaucoup peut multiplier les références décoratives.
L’analyse du soutien des affirmations rapporte aussi des cas où la preuve se trouve dans une autre citation que celle placée immédiatement à proximité. Cela justifie de vérifier l’association locale entre une phrase et sa source, au-delà de la présence d’une bibliographie.
Ajouter un contrôle humain ciblé
L’étude fait appel à des juges automatiques, avec une validation humaine de certaines tâches. Elle rapporte 93 % d’accord pour les jugements de soutien évalués, tandis que l’accord à une unité près sur les dimensions de qualité de réponse est plus limité. Ces chiffres portent sur des tâches différentes.
Dans votre audit, relire les cas ambigus et conserver le désaccord au lieu de forcer un verdict. Noter séparément factualité, pertinence et exhaustivité : une affirmation correctement sourcée peut ne pas répondre à la question.
Ce que cet audit ne permet pas d’attribuer
Les traces observées n’exposent pas les mécanismes internes des plateformes. Une différence peut venir du modèle, des instructions du système ou de l’outil de recherche. Les populations, langues et usages sont également limités. Ces résultats décrivent un protocole et une période, pas un classement permanent de fournisseurs. Les sections officielles Grounding of Claims et Limitations ont complété le fichier local tronqué ; la couverture de lecture reste ciblée et tracée.
Source et statut
Source principale : Characterizing Web Search by Conversational LLM Agents: From Search Decisions and Strategies to Results and Responses, prépublication ArXiv 2609.19244v1 · PDF. Les résultats rapportés sont ceux des auteurs ; les conseils de méthode sont une interprétation éditoriale. Publication éditoriale, sans reproduction expérimentale dans cette session.
Compléments officiels effectivement consultés : 5.2 Grounding of Claims · Limitations. Lecture partielle ; voir les passages et limites consignés dans la frontmatter.