
Article · IA & agents
Prédire le toucher d’une main à partir d’une vidéo égocentrée
TouchSight estime force et contact à partir d’images RGB sans gant instrumenté, en combinant supervision tactile, augmentation générative et géométrie de la main.
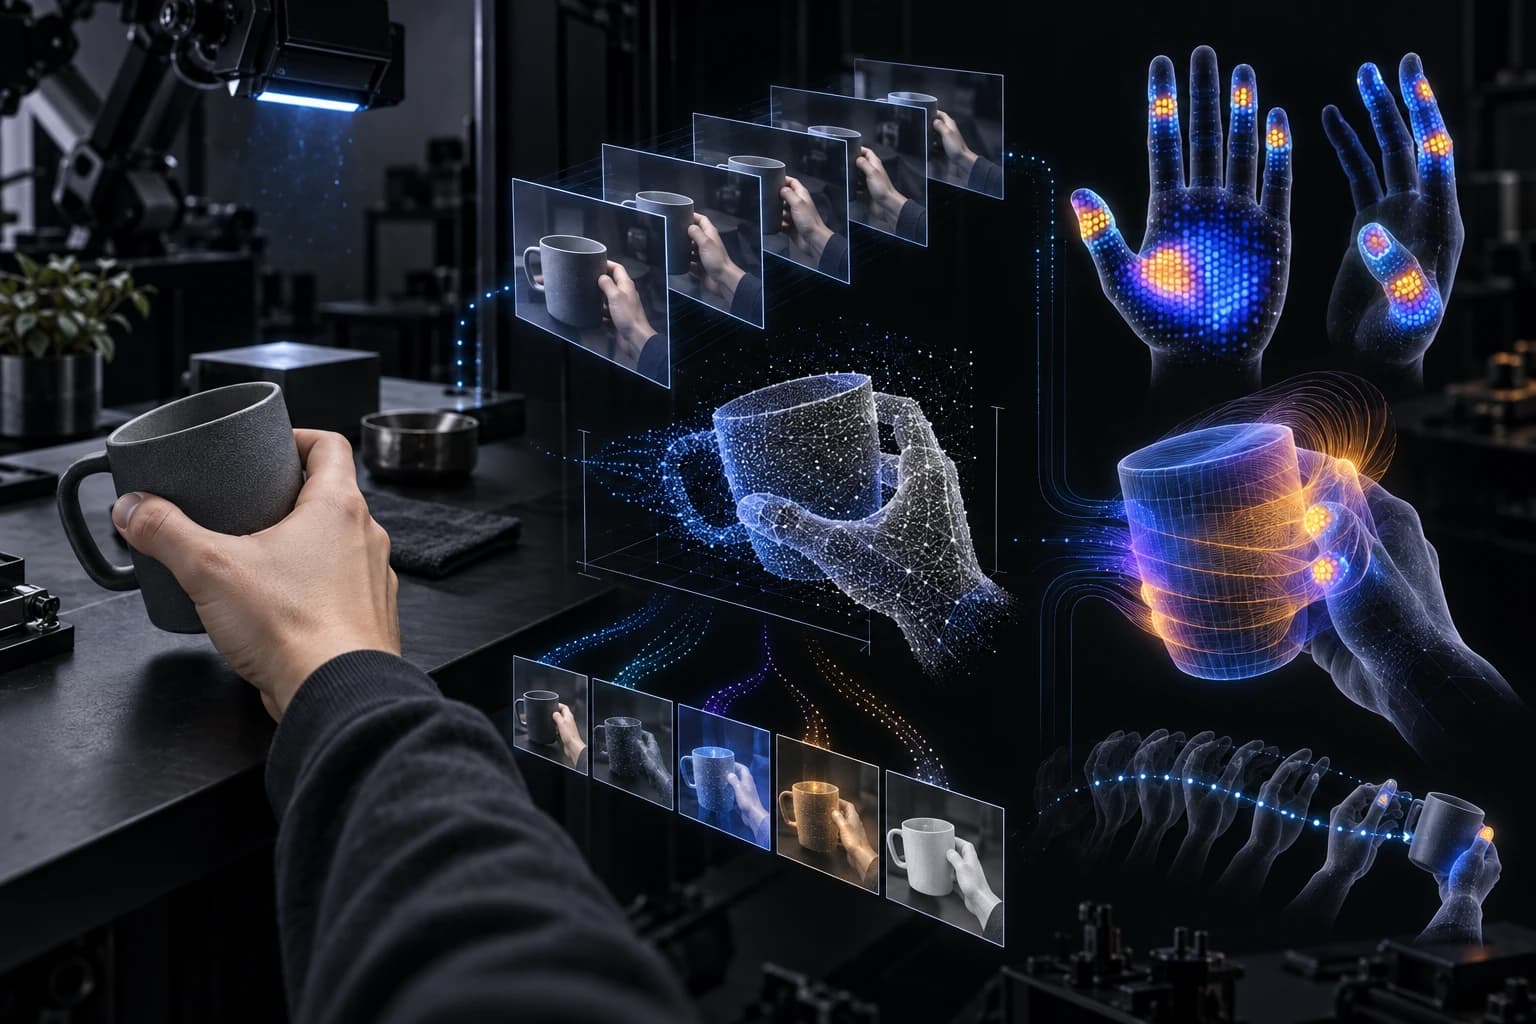
Voir la force sans capteur
TouchSight cherche à prédire la force de contact dense d’une main à partir d’une vidéo monoculaire égocentrée. Le système utilise HumanTouch pour les mesures de gant, TwinTouch pour transférer l’apparence vers une main nue, et cinq datasets de manipulation pour la supervision géométrique du contact.
Une supervision mixte
Le modèle organise les taxels par régions de doigts et de paume, puis combine une représentation visuelle géométrique, une modélisation temporelle et des pertes de force et de contact. Sur HumanTouch, la configuration complète rapporte une MAE de 1,639 et une corrélation temporelle de Pearson de 0,567. Sur TwinTouch, l’ajout des données d’apparence générée réduit la MAE active à 10,026 contre 12,077 sans AIGC.
Généraliser au contact
Sur OakInk2, TouchSight atteint une AUROC de 0,820 et un F1 de 0,373 pour le contact MANO binaire, avec une précision de 0,467. Les vidéos naturelles Ego-Exo4D, Ego4D et EgoDex servent seulement à une évaluation qualitative, car elles ne fournissent pas de vérité terrain tactile mesurée.
Interprétation éditoriale : séparer force, contact et apparence
Un agent de manipulation doit savoir si une sortie vient d’un capteur, d’une géométrie reconstruite ou d’une apparence synthétique. La corrélation temporelle et les métriques sur les taxels actifs sont plus informatives qu’une erreur moyenne dominée par les zones sans contact.
Limites et statut de la source
Une partie de la supervision est générée ou dérivée de la géométrie, et les vidéos naturelles n’ont pas de mesure tactile de référence. Le modèle prédit une force plausible, pas une mesure physique certifiée. Les performances peuvent varier avec la main, l’objet, l’occlusion, la caméra et les interactions hors des distributions d’entraînement.
Source
« TouchSight: Bare-Handed Tactile Prediction from Egocentric Video via Generative Visual Augmentation », ArXiv 2609.20414v1 : résumé et preprint, PDF.