
Article · IA & agents
MERIT-Rank : confronter le sens, l’intention et les preuves avant de reclasser
Lecture critique de MERIT-Rank : trois perspectives de pertinence, une synthèse et des résultats de reranking à interpréter dans leur protocole.
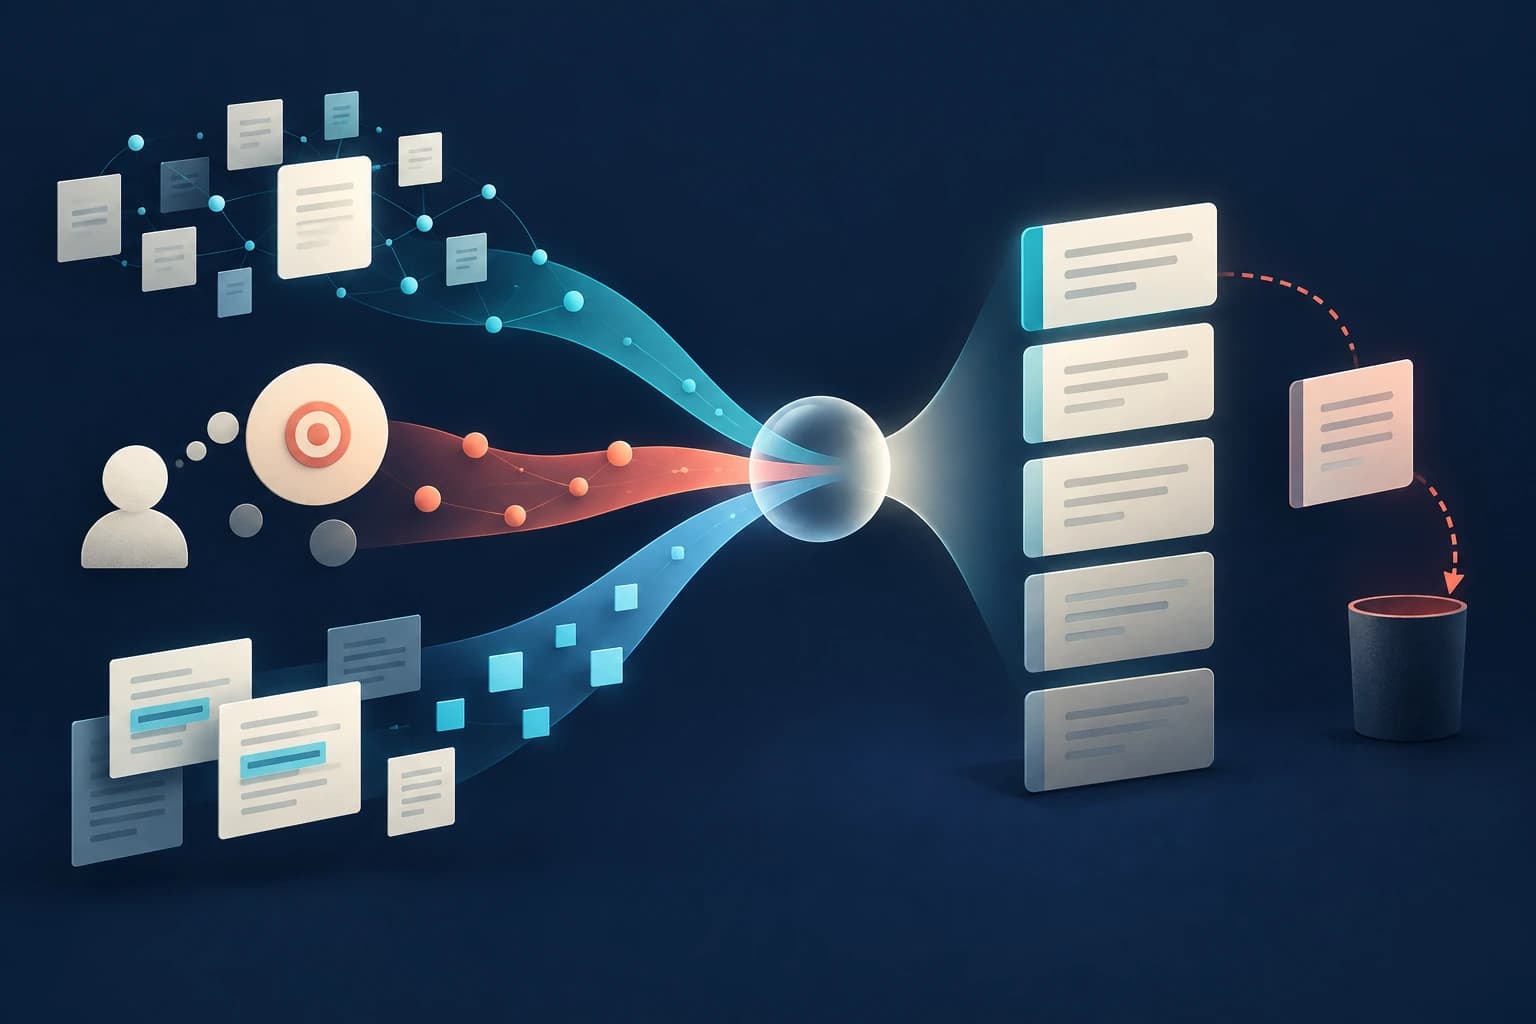
Trois raisons différentes de juger un document pertinent
Une page peut reprendre les mots d’une question sans y répondre. Une autre peut répondre à l’intention générale sans fournir le fait précis recherché. Le preprint MERIT-Rank organise ces distinctions dans un système de reclassement : une première recherche fournit des documents candidats, puis le modèle examine leur pertinence sous plusieurs angles.
Les auteurs distinguent l’alignement sémantique, la satisfaction de l’intention et l’appui sur des passages explicites. Chaque perspective produit un raisonnement et un classement ; une étape de synthèse rassemble ensuite ces contributions. Il ne s’agit pas de trois experts indépendants : le papier précise que les trajectoires proviennent du même modèle. Leur diversité est une hypothèse de complémentarité, pas une garantie statistique.
Une méthode qui comprend aussi un apprentissage
MERIT-Rank ne se réduit pas à demander trois avis dans un prompt. Les données de supervision comportent des trajectoires produites avec DeepSeek-R1 et un résultat synthétisé. Le modèle apprend d’abord ce format par ajustement supervisé, avant une optimisation progressive de la politique de classement.
Cette progression répond à une difficulté décrite par les auteurs : avec de longs raisonnements, le modèle peut sauter les analyses intermédiaires et produire directement un ordre. Évaluer seulement la forme de la réponse laisserait passer ce phénomène. Il faut mesurer la qualité du classement final et vérifier l’utilité des étapes ajoutées.
Ce que montrent les comparaisons
Le protocole couvre BRIGHT, orienté raisonnement, TREC et sept ensembles BEIR. La métrique annoncée est le NDCG@10. Sur BRIGHT, l’ablation du modèle 7B donne 37,13 pour le système complet, contre 35,29 sans synthèse et 32,18 sans l’ensemble des raisonnements. Ces valeurs constituent des comparaisons internes au protocole du papier.
L’intérêt de cette ablation est de distinguer la présence de plusieurs trajectoires de leur intégration effective. La suppression de la synthèse pénalise le résultat rapporté. Cela soutient l’utilité de l’agrégation dans cet entraînement ; cela ne démontre pas que multiplier arbitrairement les raisonnements améliore tout moteur.
Comment utiliser cette lecture
Pour évaluer un reranker, conserver la même liste de candidats et comparer une décision directe, les perspectives séparées et leur synthèse. Examiner les cas où un document est proche du sujet mais ne satisfait pas la demande. Mesurer aussi le temps et les tokens : une amélioration de pertinence peut rester trop coûteuse pour le service visé.
Ce protocole pratique est une proposition éditoriale inspirée du papier, pas une reproduction exécutée ici.
Limites et portée
Sur BRIGHT, des requêtes enrichies servent à la recherche initiale ; elles ne sont pas données au reranker. Cette distinction compte pour attribuer les gains. Les résultats ne constituent ni une garantie de factualité des réponses d’un RAG, ni une mesure de latence de votre application. L’extraction locale est tronquée ; les sections officielles sur l’optimisation progressive et l’analyse ont complété la lecture. Les autres sections et annexes ne sont pas attestées comme intégralement lues.
Source et statut
Source principale : Think Thrice Before Reranking: Multi-perspective Evidence and Reasoning Integration for Text Reranking, prépublication ArXiv 2609.20131v1 · PDF. Les résultats rapportés sont ceux des auteurs ; les conseils de méthode sont une interprétation éditoriale. Publication éditoriale, sans reproduction expérimentale dans cette session.
Compléments officiels effectivement consultés : Progressive Rank Policy Optimization · Analysis. Lecture partielle ; voir les passages et limites consignés dans la frontmatter.