
Article · IA & agents
Rendre le federated learning robuste à l’incertitude des clients
BiDRO-FL combine des boules de Wasserstein locales et une incertitude sur les poids des clients pour formaliser un apprentissage fédéré distributionnellement robuste.
Deux incertitudes au lieu d’une
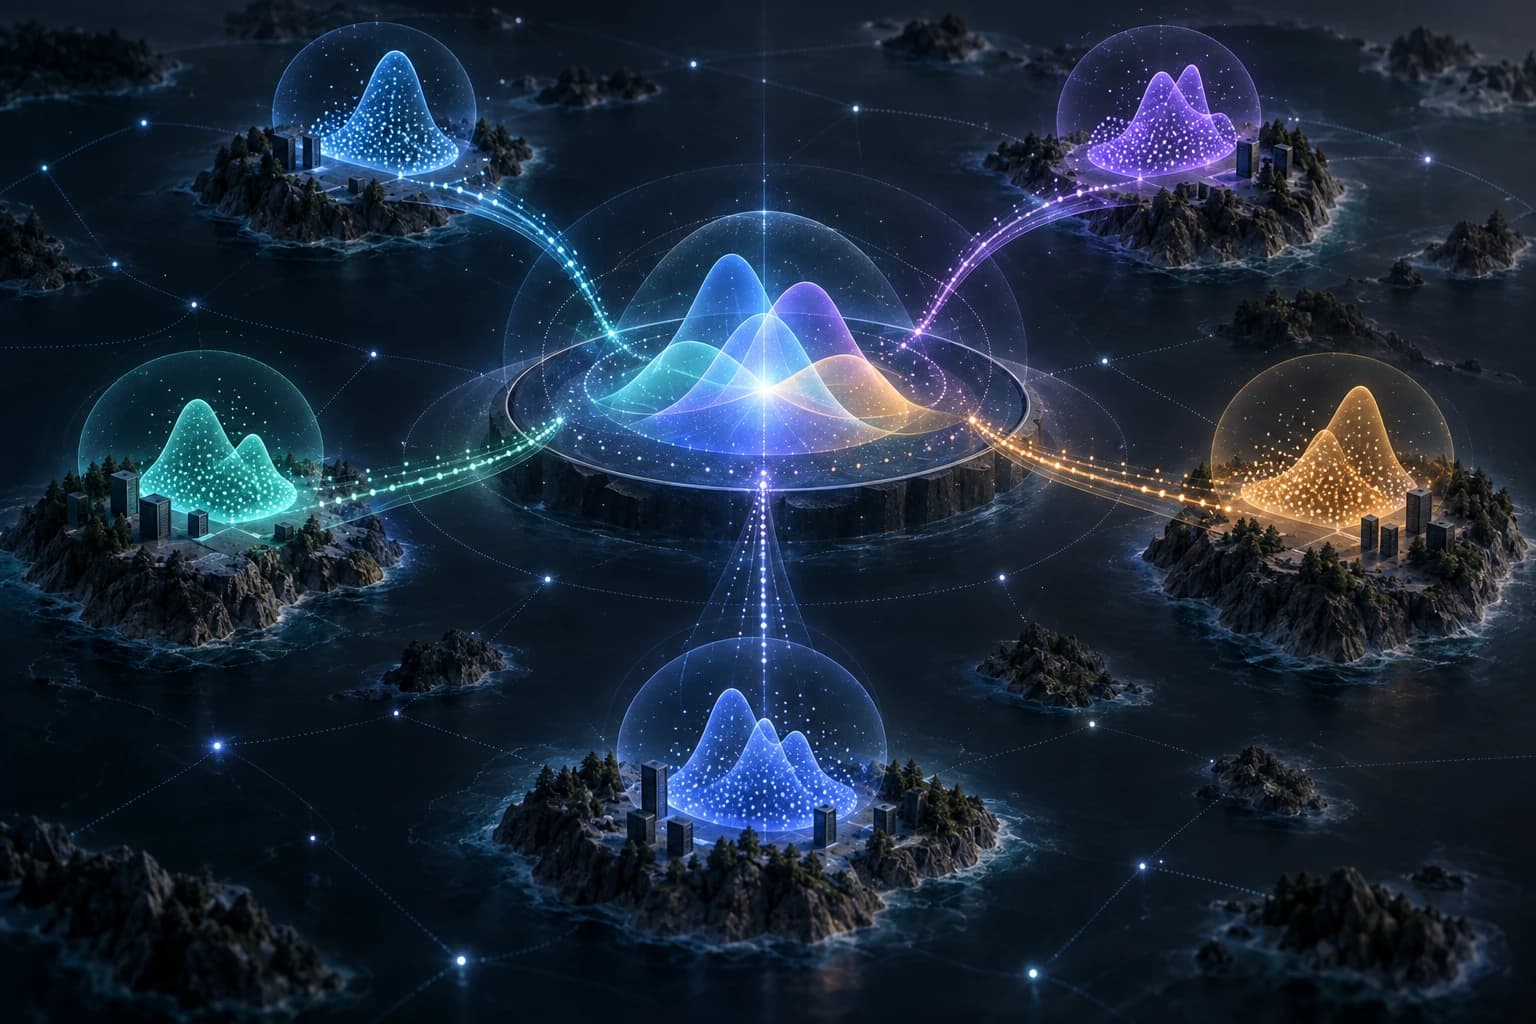
« Distributionally Robust Federated Learning with Multi-Source Data » part du fait que chaque client n’observe qu’un échantillon local et que la proportion réelle des clients peut être inconnue. Le cadre place chaque distribution locale dans une boule de Wasserstein, puis considère aussi l’ensemble des mélanges possibles entre clients.
Une ambiguïté globale
Le problème MW-DRO cherche une décision qui minimise le pire coût attendu sur cette union de mélanges. Les auteurs dérivent une garantie de couverture à échantillon fini et une borne de performance hors échantillon, sous des hypothèses de support compact et de régularité. Une relaxation pénalisée rend ensuite le problème calculable dans leur algorithme BiDRO-FL.
La convergence rapportée
La méthode alterne une mise à jour de la décision et des poids de clients, avec estimation des gradients par échantillonnage local. Le théorème de convergence annoncé donne un écart en O(T⁻¹ᐟ² + ε), où ε représente notamment l’erreur d’estimation ou d’approximation retenue dans le cadre.
Interprétation éditoriale : pondérer n’est pas corriger
Un agent fédéré peut ajuster le poids d’un client, mais cela ne suffit pas à corriger une distribution locale mal estimée. Séparer incertitude intra-client et incertitude de mélange rend la décision plus auditable : on sait si la prudence vient des données, de l’hétérogénéité ou du protocole d’agrégation.
Limites et statut de la source
La démonstration empirique repose sur une régression linéaire fédérée synthétique avec cinq clients et des tailles d’échantillon de 30, 40, 80, 150 et 300. Les garanties supposent des conditions mathématiques sur les pertes, les supports et les distances entre distributions. Les auteurs identifient comme suite le développement d’algorithmes plus efficaces en communication et moins dépendants d’un serveur central.
Source
« Distributionally Robust Federated Learning with Multi-Source Data », ArXiv 2609.20501v1 : résumé et preprint, PDF.