
Article · IA & agents
Pourquoi un modèle vidéo doit être évalué sur le temps, pas seulement le texte
AVTrace décompose le raisonnement audio-visuel en localisation, synchronisation, ordre des événements et compréhension conditionnelle.
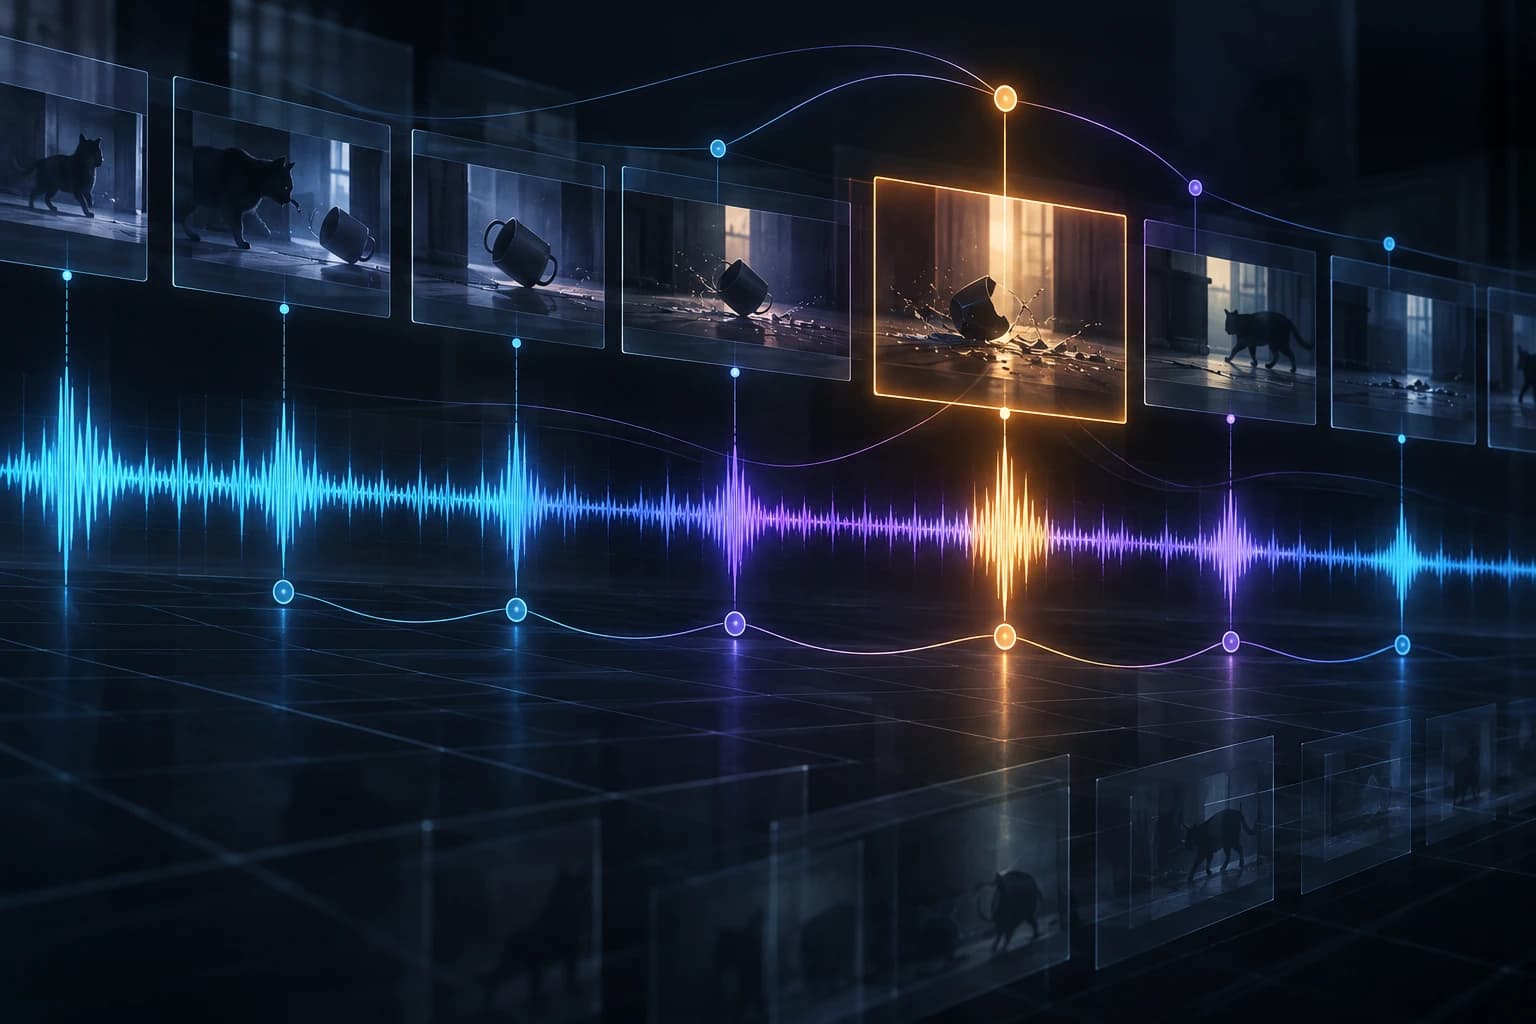
Décrire n’est pas localiser
Un modèle peut produire une phrase qui ressemble à la référence sans identifier le bon moment dans une vidéo. AVTrace, pour « Audio-Visual Temporal Reasoning Assessment and Capability Evaluation », construit un diagnostic autour de cette différence.
Le benchmark couvre sept familles de tâches : début d’événement, intervalle temporel, vérification de synchronisation audio-vidéo, prédiction de l’étape suivante, localisation intermodale, parsing de chaînes et compréhension conditionnée par un événement.
Un benchmark décomposé
AVTrace contient 34 114 exemples d’entraînement, un développement de 3 500 exemples et un test de 7 000 exemples. Les auteurs évaluent cinq modèles omni ouverts dans leurs configurations d’entrée respectives, puis normalisent les réponses avant un scoring déterministe.
Cette précision est importante : les systèmes ne reçoivent pas nécessairement la même fréquence d’images, la même fenêtre audio ou le même budget de média. Le résultat caractérise donc une chaîne modèle-interface, pas uniquement un nombre abstrait de paramètres.
Résultats annoncés
Les cinq systèmes évalués restent sous le baseline de majorité du test, fixé à 0,556, sur la vérification de synchronisation. Les scores sont également faibles sur le parsing de chaînes et la localisation ou compréhension conditionnée par événement. Un post-entraînement à paramètres efficaces améliore Gemma4-E4B-it sur plusieurs métriques.
Les perturbations du développement montrent une sensibilité à la suppression de modalités, à l’ordre des images et à la configuration d’échantillonnage de Qwen3-Omni-30B. Les auteurs précisent qu’une telle sensibilité ne révèle pas à elle seule la cause interne de l’erreur.
Ce que le benchmark évite
Un score de similarité textuelle n’est pas un substitut à une intersection temporelle ou à un ordre correct. Pour un agent qui doit déclencher une action sur une vidéo, il faut donc conserver les timestamps, les spans et les chaînes d’événements comme sorties vérifiables.
Limites
Les références sont dites silver-standard et plusieurs étapes sont assistées par des modèles. Les interfaces d’entrée diffèrent entre systèmes et la couverture linguistique reste incomplète. Les auteurs demandent un sous-ensemble vérifié par des humains avant d’en tirer des conclusions plus fortes.
Source primaire : arXiv:2609.19991v1, PDF. Les résultats et limites sont ceux des auteurs ; les implications pour des agents vidéo sont une interprétation éditoriale.
Brief visuel
Composition 1536×1024 : bande vidéo abstraite et onde audio synchronisées sur une ligne temporelle, plusieurs événements localisés par des repères lumineux, un repère décalé volontairement en comparaison. Palette bleu nuit, cyan, magenta et blanc. Aucun texte ou logo.